Тренд пошуку "Aws"
Стрічка оновлень
Коментарі
ІМІ рекомендує
17°
лі чже мьонзаслужений артист українибензинбенфіка11 жовтня святоентоні джошуавійськова службаріядтайсон фьюриднепрнафтапоїздєвроуніанпенсіонерліонель мессіінтер маямі – ді сі юнайтедджон ф'юрісергій станіславович реброванатолій трубінмонако – тулузанаполі – фрозінонеламін ямальбаварія мюнхендональд трампукраїнська правдапсж – ле-манреал мадрид – вільярреалметрополітен11 жовтняЩе..

1 Вер. 10:49 Технології
Федеральна торгова комісія США (Federal Trade Commission, FTC) разом із 22 штатами подала до суду на Amazon, звинувативши компанію в незаконному завищенні вартості реклами для продавців. За версією регулятора, приховані зміни в системі рекламних аукціонів коштували рекламодавцям щонайменше 20 мільярдів доларів і зрештою призвели до підвищення цін для покупців. Позов подали до федерального суду Західного округу штату Вашингтон, повідомляє Reuters.
FTC стверджує, що Amazon роками таємно підвищувала мінімальну вартість рекламних місць уже після того, як рекламодавці зробили свої ставки. В позові йдеться: “Amazon змогла отримати мільярди доларів прибутку — коштом своїх клієнтів, які купують рекламу на аукціонах”.
За даними FTC, компанія запровадила так звану систему “м'якого резерву” (soft reserve), яка змінювала традиційний принцип рекламних торгів. Якщо раніше переможець сплачував лише трохи більше, ніж учасник із другою за величиною ставкою, то після змін Amazon могла встановлювати вищу мінімальну ціну вже після завершення аукціону. У позові зазначається, що всередині компанії цей механізм називали “регулюванням ціни постфактум”.
ВАС ЗАЦІКАВИТЬ
Як купувати на Amazon з України: покрокова інструкція у 2026 році
FTC також стверджує, що Amazon іноді сама брала участь в аукціонах, фактично підвищуючи ставки для інших рекламодавців. За оцінкою регулятора, втручання компанії торкнулося до 80% аукціонів із розміщення реклами Sponsored Products. Особливо часто додаткові націнки застосовувалися під час різдвяного сезону та інших періодів високого попиту.
FTC вважає, що зростання рекламних витрат зрештою перекладалося на покупців через підвищення цін на товари. Голова комісії Ендрю Фергюсон заявив, що ця практика вплинула навіть на вартість продуктів харчування та товарів повсякденного попиту.
Amazon категорично відкинула звинувачення. У компанії заявили, що її рекламна система спрямована на показ найбільш релевантних оголошень і що твердження FTC базуються на неправильному розумінні принципів роботи рекламних аукціонів.
“Підхід Amazon до ціноутворення суперечить будь-яким припущенням про шкоду для споживачів”, — заявили в компанії.
ВАС ЗАЦІКАВИТЬ
Amazon почне використовувати контент стримерів Twitch для навчання генеративного ШІ
За словами Amazon, середня вартість кліку для рекламодавців між 2019 і 2024 роками залишалася стабільною, тоді як продажі, отримані завдяки рекламі, зростали. Компанія також стверджує, що з 2021 по 2025 рік допомогла рекламодавцям заощадити близько 8 мільярдів доларів, а середні виграшні ставки в аукціонах Sponsored Products за цей час скоротилися на 50%.
Справу розглядають на тлі стрімкого зростання рекламного бізнесу Amazon. Компанія вже є третьою за величиною платформою цифрової реклами у світі після Google та Meta, а її рекламний виторг у другому кварталі зріс на 26% — до 19,8 мільярда доларів.
Це вже не перший великий конфлікт Amazon із FTC. Минулого року компанія погодилася сплатити 2,5 мільярда доларів штрафів і компенсацій у справі про сервіс Prime, а наступного року має постати перед судом ще й у справі про можливу незаконну монополію та зловживання щодо сторонніх продавців.
Водночас ринкова капіталізація Amazon вперше в історії перевищила позначку в 3 трильйони доларів, зробивши її п'ятою компанією у світі після Apple, Microsoft, Alphabet і Nvidia, яка досягла такого результату. Головним драйвером зростання став підйом хмарного підрозділу Amazon Web Services (AWS) на тлі глобального буму штучного інтелекту, використання власних чипів Trainium, а також масштабні інвестиції корпорації в ШІ-сектор.
 Перейти на zn.ua
Головні технологічні бренди вже розподілили найпопулярніші формати, але організатори залишили простір для нових партнерств і несподіваних можливостей.
Конференція TechCrunch Disrupt 2026 пройде 13–15 жовтня у виставковому центрі Москоун-Вест у Сан-Франциско. Подія збере стартапи, інвесторів, керівників технологічних компаній і представників індустрії з різних країн. Організатори продовжують формувати коло брендів-партнерів, які підтримають тематичні сцени та простори для професійного спілкування.
Як зазначають Techcrunch
Партнери сцен TechCrunch Disrupt 2026
Google for Startups стане партнером сцени, присвяченої штучному інтелекту. У її програмі передбачена участь представників OpenAI, Databricks, Luma AI та інших технологічних компаній. На цій сцені обговорюватимуть розвиток ШІ, нові продукти та вплив інтелектуальних систем на бізнес.
Нью-Йоркська фондова біржа підтримає сцену для засновників стартапів. Її учасники зосередяться на залученні капіталу, злиттях і поглинаннях, а також інших рішеннях, важливих для розвитку молодих компаній.
Mastercard виступить партнером зони для нетворкінгу, де учасники зможуть налагоджувати ділові контакти. Компанія SEW.AI підтримає нову сцену “Розумні системи”. Її програма охопить питання розвитку інфраструктури штучного інтелекту та використання технологій для оновлення електромереж.
Бренди, що підтримують конференцію не перший рік
Окремі напрями TechCrunch Disrupt уже не вперше підтримують Google for Startups, Аерокосмічна корпорація, Qualcomm, Fidelity Private Shares і Greenfield. Їхня участь охоплює різні сцени та формати конференції, пов’язані зі стартапами, технологіями та інвестиціями.
Fidelity також стане головним партнером Founder Summit – заходу для засновників компаній, який запланували на 4 листопада в Бостоні.
Масштаб події та партнерські формати
Очікується, що TechCrunch Disrupt 2026 відвідають близько 10 тисяч учасників зі 113 країн. Приблизно 40% аудиторії становитимуть керівники найвищої ланки.
За 15 років існування Startup Battlefield 200 випускники програми сукупно залучили понад 32 мільярди доларів. Найбільш затребувані спонсорські формати вже зайняті: серед них напрям штучного інтелекту, зона для нетворкінгу, павільйон стартапів і бейджі учасників.
Водночас для брендів ще доступні партнерські можливості в контентній та виставковій частинах TechCrunch Disrupt 2026. Дедлайн для розміщення бренду на стрічках для бейджів завершився 28 серпня.
Інші теми, які вам можуть сподобатися:
- TechCrunch Disrupt 2026 представить AI Stage, де експерти Anthropic, OpenAI, AWS та інших компаній обговорять ШІ, безпеку агентних систем і майбутнє стартапів.
- Стартапи можуть забронювати виставковий стіл на TechCrunch Disrupt 2026 у Сан-Франциско за ціною від 12 500 доларів і представити свої продукти інвесторам, клієнтам та партнерам.
- Віджай Панде обирає вибіркову модель венчурного інвестування: менше угод, ретельніший відбір стартапів і глибша підтримка засновників після вкладення коштів.
 Перейти на mezha.net

29 Сер. 21:11 Технології
У Копенгагені технологічні лідери з’ясували, що справжня боротьба за майбутнє ШІ точиться не лише навколо інновацій, а й навколо влади.
На конференції TechBBQ у Копенгагені представники європейської технологічної індустрії зосередилися не лише на можливостях штучного інтелекту, а й на питанні контролю над ним. Інвестори, засновники стартапів і керівники компаній обговорювали, чи здатна Європа самостійно володіти моделями штучного інтелекту та обчислювальною інфраструктурою, не покладаючись повністю на технологічні ресурси США і Китаю.
Як повідомляє Techcrunch
Тема технологічної суверенності стала особливо відчутною після того, як моделі штучного інтелекту Mythos і Fable компанії Anthropic раніше цього року виявилися недоступними для користувачів за межами Європи. Для окремих стартапів обмеження вплинули на роботу команд розробників. Водночас частина учасників конференції вважала, що залежність від закордонних платформ поки не становить для європейського бізнесу критичної загрози.
Тема суб’єктності на TechBBQ цього року була особливо доречною, адже розмова змістилася від того, що може робити штучний інтелект, до того, що ми насправді готові дозволити йому робити.
– Еллен де Бревер, бізнес-ангелка та керівниця партнерств Cellerator Фонду Novo Nordisk
Еллен де Бревер наголосила, що учасники дискусій дедалі частіше говорять не про інтелектуальні можливості машин, а про відповідальність людей, які ухвалюють рішення щодо їхнього використання. Поряд із розвитком штучного інтелекту на TechBBQ також порушували теми жіночого здоров’я, партнерства між скандинавськими та африканськими інноваційними екосистемами, а також залучення інвестицій для масштабування європейських компаній.
Штучний інтелект, приватність і технологічна суверенність
Однією з ключових дискусій стала розмова про те, чи можуть системи штучного інтелекту розвиватися без посилення масового збору персональних даних. Президентка Signal Мередіт Віттакер розкритикувала вбудовування цифрових асистентів і автономних агентів в операційні системи, зокрема моделі інтеграції на зразок використання ChatGPT в iMessage.
Ця епоха штучного інтелекту створює механізм збору даних. Лабораторії штучного інтелекту використовують влучний маркетинг, щоб люди забували про побічні наслідки накопичення такої кількості даних. Попит на приватність усе ще величезний, і з огляду на занепокоєння суверенністю тут будуть клієнти.
– Мередіт Віттакер, президентка Signal
Питання суверенності пов’язане не лише із захистом даних, а й із розподілом технологічної влади. Співзасновник Stability AI та Intelligent Internet Емад Мостак зазначив, що концентрація обчислювальних потужностей, моделей і даних у невеликої кількості лабораторій може впливати на економічну стійкість і політичну автономію цілих держав.
Учасники конференції обговорювали ризик ситуації, за якої ключові цифрові сервіси, інструменти розробки та інтелектуальні агенти контролюватимуться обмеженим колом глобальних корпорацій. За такого сценарію країни, які не мають власної технологічної бази, можуть втрачати можливість самостійно визначати правила використання штучного інтелекту.
Якщо інтелектуальні агенти виконуватимуть когнітивну працю, а роботи дедалі більше братимуть на себе фізичну, людство може наближатися до явища, значно більшого за чергову технологічну революцію. Доведеться переосмислити власність, працю, демократію, економічну участь і зрештою навіть те, хто зможе бути частиною суспільства.
– Міа Негру, директорка з адвокації та взаємодії некомерційної організації “Життя зі штучними інтелектами”
Людський контроль залишається головним питанням
Попри занепокоєння щодо автономних систем, даних і залежності від великих технологічних платформ, головним лейтмотивом TechBBQ стало питання людського контролю. Учасники обговорювали, хто встановлюватиме межі для штучного інтелекту, кому належатимуть критично важливі моделі та інфраструктура і як зберегти право суспільства впливати на технологічні рішення.
Неформальні зустрічі за підтримки Lovable, Nvidia, OpenAI, AWS Startups і HSBC стали продовженням цих розмов поза панелями. Конференція показала, що в час стрімкого розвитку штучного інтелекту безпосередній діалог між людьми залишається необхідним для пошуку відповідальних рішень.
Ще цікаві матеріали:
- Китайські автовиробники активно інвестують у гуманоїдних роботів. XPeng залучила понад 900 мільйонів доларів, а інші компанії готують власні технологічні проєкти.
- Опитування YouGov показало, що американці дедалі частіше виступають проти камер Flock через побоювання щодо приватності та доступу поліції до даних.
- QuTwo, фінська лабораторія AI та квантових обчислень, залучила €25 млн і отримала оцінку €325 млн, зміцнюючи європейський потенціал у корпоративному ШІ та гібридних рішеннях.
 Перейти на mezha.net

28 Сер. 05:52 Технології
Платформа отримала інструменти, які мають краще чути співрозмовників навіть у складних умовах і помітно спростити роботу із записами.
Про це повідомляє The Verge.
Google представила оновлення для платформи Gemini Audio, до якого увійшли моделі Gemini 3.5 Live, Gemini 3.5 Live Experimental і Gemini 3.5 Transcribe. Нові інструменти покликані поліпшити роботу голосових функцій штучного інтелекту, зокрема розпізнавання мовлення в умовах фонового шуму, перебивань співрозмовників і використання професійної лексики.
Ключовою новинкою стала Gemini 3.5 Transcribe – модель для транскрипції аудіо в реальному часі. У Google зазначили, що вона є помітним кроком уперед у порівнянні з попередньою системою Chirp 3: модель краще працює з різними мовами та зменшує кількість помилок під час розпізнавання слів.
Можливості Gemini 3.5 Transcribe для транскрипції аудіо
Gemini 3.5 Transcribe підтримує понад 85 мов і може перетворювати усне мовлення на структурований текст без зайвого ручного редагування. Модель автоматично форматує транскрипцію та прибирає поширені слова-паразити, зокрема “ем” і “ее”.
Готовий текст можна редагувати голосовими командами. Це дає змогу швидше виправляти фрагменти транскрипції, змінювати формулювання або уточнювати запис без використання клавіатури.
Окремою функцією став користувацький словник. До нього можна додавати спеціалізовані терміни, назви, професійні поняття або нестандартні варіанти написання. Завдяки цьому Gemini 3.5 Transcribe може точніше адаптувати розшифровку до конкретної тематики – наприклад, ділової розмови, технічної лекції чи профільного інтерв’ю.
Під час обробки попередньо записаного аудіо модель здатна розпізнавати до трьох співрозмовників. Вона також додає часові мітки до кожного слова, що спрощує пошук потрібних моментів у записі. Такий інструмент може застосовуватися для розшифрування зустрічей, інтерв’ю, лекцій і розмов із кількома учасниками.
Gemini 3.5 Live та голосовий чат
Разом із моделлю для транскрипції Google оновила технології голосового спілкування в Gemini. Gemini 3.5 Live створена для природнішої взаємодії під час діалогу: вона краще реагує на перебивання, точніше розпізнає мовлення та може працювати з візуальною інформацією в режимі реального часу.
Gemini 3.5 Live Experimental призначена для складніших завдань. Вона може пояснювати виконання дій поетапно, щоб користувачеві було легше стежити за послідовністю роботи моделі та логікою її відповідей.
Де доступні нові моделі Gemini Audio
Оновлені можливості Gemini Audio вже почали впроваджувати для англомовних користувачів застосунку Gemini на macOS. Частина функцій також доступна в диктуванні Rambler на Android для вибраних мов.
Розробники можуть випробувати Gemini 3.5 Transcribe, Gemini 3.5 Live і Gemini 3.5 Live Experimental через Gemini API, AI Studio та Antigravity у форматі публічної попередньої версії.
Google також анонсувала появу підтримки нових функцій Gemini Audio у браузері Chrome найближчим часом. Розширення доступності моделей має зробити голосове введення, транскрипцію та роботу зі звуком зручнішими в повсякденних цифрових сервісах.
Схожі новини для вас:
TechCrunch Disrupt 2026 представить AI Stage, де експерти Anthropic, OpenAI, AWS та інших компаній обговорять ШІ, безпеку агентних систем і майбутнє стартапів.
Google представила Nano Banana 2 Lite – швидку й дешеву модель для генерації зображень і відео, що створює зображення за 4 секунди й коштує $0.034 за 1000 зображень.
The post Google оновила Gemini Audio: нові моделі покращують транскрипцію та голосові діалоги first appeared on Межа. Новини України..
 Перейти на mezha.net

27 Сер. 11:15 Технології
NVIDIA показала неймовірні фінансові результати за другий квартал 2026 року. Чистий прибуток компанії досяг 59,7 млрд доларів, що на 126% більше, ніж роком раніше. Виручка також встановила рекорд – 96,2 млрд доларів, збільшившись на 106%. Основним двигуном такого зростання залишається стрімкий розвиток інфраструктури штучного інтелекту.
Найбільше NVIDIA заробляє на дата-центрах. За квартал цей напрям приніс компанії 89 млрд доларів, що на 117% більше у річному вимірі. Таким чином, на дата-центри припало понад 92% усієї виручки NVIDIA. Компанія очікує, що наступного кварталу її загальний дохід зросте приблизно до 108 млрд доларів.
Паралельно NVIDIA розширює співпрацю з Amazon Web Services. AWS планує розгорнути ще 2 мільйони графічних процесорів NVIDIA у своїй інфраструктурі протягом 2027-2028 років. Це додаткові чипи до понад мільйона GPU, які Amazon уже планувала встановити раніше. У новій поставці будуть представлені покоління Blackwell Ultra, Rubin та Rubin Ultra.
Партнерство компаній не обмежиться лише графічними процесорами. AWS також використовуватиме процесори NVIDIA Vera, а технології NVIDIA інтегрують із мережевою інфраструктурою Amazon. Окремо компанії планують створити інфраструктуру для штучного інтелекту уряду США, яка включатиме близько 100 тисяч GPU.
Результати NVIDIA показують, наскільки масштабним став попит на обчислювальні потужності для ШІ. Компанія вже заробляє десятки мільярдів доларів за квартал, а попит поки перевищує можливості постачання. Якщо темпи розвитку AI-інфраструктури збережуться, NVIDIA може продовжити встановлювати рекорди навіть попри зростання вартості компонентів і проблеми з їхньою доступністю.
Запис NVIDIA заробила рекордні 59,7 млрд доларів на тлі буму штучного інтелекту спершу з'явиться на iTechua - Новини про смартфони, гаджети і різні девайси.
 Перейти на itechua.com
27 Сер. 03:17 Технології
Попит на обчислення для штучного інтелекту змусив компанію переглянути масштаб партнерства, яке ще недавно здавалося рекордним.
Як пише Techcrunch
Amazon Web Services суттєво збільшує закупівлю чипів Nvidia для розвитку хмарної інфраструктури штучного інтелекту. У 2027–2028 роках AWS планує встановити у своїх дата-центрах додаткові 2 млн графічних процесорів Nvidia.
Таким чином Amazon фактично втричі нарощує початковий обсяг замовлення. Лише п’ять місяців тому компанія домовилася про розгортання понад 1 млн GPU Nvidia в інфраструктурі AWS, а тепер вирішила різко розширити ці плани через вищий за очікуваний попит.
Які чипи Nvidia отримає Amazon Web Services
До нового контракту увійшли прискорювачі Blackwell Ultra, Rubin і Rubin Ultra. Ці графічні процесори призначені для навчання, запуску та масштабування моделей штучного інтелекту.
Фінансові деталі угоди Amazon і Nvidia не розкрили. Водночас з огляду на ціну сучасних ШІ-прискорювачів загальна вартість замовлення може становити десятки мільярдів доларів.
Крім GPU, AWS інтегрує в інфраструктуру низку інших рішень Nvidia, зокрема:
- мережеве обладнання;
- відкриті моделі штучного інтелекту;
- центральні процесори;
- програмне забезпечення для обробки даних;
- платформу для робототехніки.
Компанії пояснюють розширення партнерства зростанням потреби в обчислювальних ресурсах серед стартапів, великих корпорацій, лабораторій штучного інтелекту та державних установ.
Amazon розвиває власні чипи, але зберігає ставку на Nvidia
Паралельно AWS продовжує просувати власні процесори. Зокрема, чипи Trainium компанія позиціонує як альтернативу Nvidia H100 і Blackwell для глибинного навчання. Процесори Graviton на архітектурі Arm конкурують із серверними рішеннями Intel та AMD.
Попри розвиток власних технологій, Nvidia залишиться одним із ключових постачальників для масштабування AWS. Разом із графічними процесорами компанія має постачати Amazon невизначену кількість процесорів Vera.
Важливо для галузі те, що ШІ вже виконує продуктивну й корисну роботу. ШІ генерує прибуткові токени… Якби ми мали більше обчислювальних потужностей, ми могли б генерувати більше прибуткових токенів, що забезпечує більший прибуток для всіх сервісів. Саме на цьому етапі ми перебуваємо, і саме тому всі активно інвестують.
– Jensen Huang
ШІ Nvidia допоможе роботизації складів Amazon
Угода також передбачає використання технологій Nvidia для роботизації складів Amazon. Компанія розраховує застосовувати стек фізичного штучного інтелекту Nvidia, який включає Omniverse, Cosmos, Isaac і Jetson.
На корпоративному ринку AWS розмістить відкрите сімейство моделей Nemotron на платформах Amazon Bedrock і SageMaker. Це зміцнює позиції Nvidia в сегменті хмарних обчислень для ШІ, навіть попри намагання Amazon частково знизити залежність від зовнішніх виробників чипів.
Нове масштабне замовлення демонструє, що попит на інфраструктуру для штучного інтелекту продовжує зростати, а графічні процесори Nvidia залишаються важливою основою для розширення можливостей AWS.
Ще цікаві матеріали:
- Moonshot AI веде переговори з Microsoft, Amazon і Google про розподіл доходів від розміщення моделі Kimi K3 на хмарних платформах США.
- Nvidia отримала $96,2 млрд виручки за квартал, але стримана реакція інвесторів посилила увагу до витрат і ризиків фінансування ШІ-інфраструктури.
- Азіатські акції зросли на тлі відпочинку для сектору чипів, але різкий підйом цін на нафту через напругу в Перській затоці підвищив інфляційні ризики та тиск на облігації.
 Перейти на mezha.net
27 Сер. 01:06 Технології
Компанія продовжує скуповувати доступ до найпотужнішої інфраструктури, а новий контракт стане одним із найбільших у її історії.
Як зазначають Techcrunch
Anthropic домовилася з британським постачальником ШІ-інфраструктури Nscale про оренду обчислювальних потужностей орієнтовною вартістю $45 млрд. Угода має забезпечити лабораторії значний ресурс для розвитку та роботи систем штучного інтелекту.
Nscale заснували у 2024 році, але компанія вже працює з Microsoft. Для Anthropic вона планує надати інфраструктуру на основі нової платформи Nvidia Vera Rubin. Ця система об’єднує шість різних чипів, розрахованих на спільну роботу з великими обсягами ШІ-обчислень.
Потужності з дата-центру у Західній Вірджинії
Контракт розрахований на шість років. Обчислювальні ресурси Anthropic отримуватиме з флагманського дата-центру Nscale у Західній Вірджинії. Очікується, що вони почнуть підтримувати сервіси компанії наприкінці 2027 року.
Нова угода стала черговим великим інфраструктурним контрактом Anthropic. Компанія послідовно нарощує доступ до дата-центрів, хмарних платформ і спеціалізованих чипів, необхідних для навчання та запуску великих моделей ШІ.
Серія великих контрактів Anthropic
Протягом останніх місяців Anthropic уклала кілька домовленостей щодо обчислювальних ресурсів:
- на початку місяця компанія підписала шестирічний контракт на $10 млрд зі стартапом Volta для доступу до хмарних потужностей дата-центру в Норвегії;
- у липні Anthropic уклала угоду з AMD на $5 млрд, пов’язану з отриманням обчислювальних ресурсів;
- у травні компанія розкрила подробиці великої угоди зі SpaceX, що використовує потужності двох дата-центрів компанії Ілон Маск;
- цей контракт зі SpaceX, за наявними даними, передбачає обчислювальні ресурси на $1,25 млрд щомісяця;
- у квітні Anthropic розширила співпрацю з Amazon, Google та Broadcom, зокрема домовившись про додаткові 5 гігаватів обчислювальної потужності від Amazon.
Попит на інфраструктуру для штучного інтелекту стрімко зростає. Не лише Anthropic, а й Google, OpenAI та Meta збільшують доступ до дата-центрів і спеціалізованих прискорювачів. Потужні обчислювальні системи дедалі більше визначають можливості компаній у конкурентній боротьбі на ринку ШІ.
Корисне для прочитання:
- Anthropic об’єднала пам’ять Claude у чаті та Claude Cowork. Асистент використовує спільний контекст, а користувачі можуть переглядати, редагувати й видаляти збережені дані.
- Nscale придбає Anyscale за 1,65 мільярда доларів, щоб інтегрувати платформу на базі Ray і розширити можливості масштабування та управління AI‑обчисленнями для навчання і інференсу.
- Recursive Superintelligence підписала багаторічну угоду з AWS на близько 410 мільйонів доларів для масштабування обчислювальних ресурсів і прискорення розробки самовдосконалювальних систем.

13 Сер. 12:30 Технології
Інвестори Anthropic очікують, що компанія вийде на біржу з оцінкою $2 трильйони або більше. Про це повідомляє Financial Times. Такий показник зробить первинне публічне розміщення компанії найбільшим в історії, перевершивши вихід на IPO SpaceX. Детальніше про фінансові показники Anthropic Інвестори Anthropic розповіли Financial Times, що очікують стрімкого зростання виторгу компанії у 2026 році. За їхніми прогнозами, річний виторг може становити від $100 млрд до $120 млрд до кінця року. Йдеться про показник, який Anthropic використовує для оцінки річного виторгу на основі останніх результатів компанії. За оцінками інвесторів, протягом 2026 року цей показник може зрости більш ніж у десять разів. Водночас остаточну оцінку для IPO керівництво Anthropic поки не визначило. Самі інвестори будують власні фінансові моделі та виходять із прогнозів щодо майбутніх доходів компанії. За даними FT, зростання Anthropic у червні сповільнилося. Серед причин називають посилення конкуренції з боку китайських компаній, тиск щодо регулювання ШІ та конфлікт із урядом США. У 2026 році венчурні фонди, суверенні фонди та інші інституційні інвестори вклали в Anthropic трохи менше $100 млрд. У травні оцінка компанії вперше перевищила оцінку OpenAI — після залучення нових інвестицій вона сягнула $965 млрд. Що відомо про вихід Anthropic на IPO На початку червня 2026 року Anthropic оголосила про конфіденційне подання документів для IPO. Конфіденційний формат подання заяви дозволяє компанії пройти початковий етап перевірки без публічного розкриття фінансової та операційної інформації. Подання заяви є початковим етапом підготовки до виходу на фондовий ринок. Проведення самого первинного публічного розміщення акцій залежатиме від ринкових умов та низки інших факторів. У компанії зазначили, що кількість акцій, які планується запропонувати інвесторам, а також їхня ціна ще не визначені. Видання New York Times пише, що вихід на біржу може відбутися вже цієї осені. Попри можливий вихід OpenAI та Anthropic на біржу у 2026 році, Perplexity зберігає свої плани щодо IPO на 2028 рік. Більше про Anthropic Anthropic — це американська компанія у сфері штучного інтелекту. Її у 2021 році заснували колишні дослідники OpenAI. Одним із головних її продуктів є чатбот Claude. Як зазначають у самій компанії, це перша модель, доступна на трьох найбільших у світі хмарних платформах: Amazon Web Services, Google Cloud та Microsoft Azure. AWS залишається основним постачальником хмарних послуг та партнером з навчання Anthropic. У травні 2026 року Anthropic заявила, що в майбутньому планує відкрити публічний доступ до моделей класу Mythos — систем штучного інтелекту, здатних автоматично знаходити критичні вразливості в програмному коді. Саме цю модель Агентство національної безпеки США (NSA) використовує для власних потреб попри те, що Пентагон раніше включив компанію до списку ризикованих постачальників. Читайте також: Claude буде маркувати написаний текст прихованими водяними знаками. Як це працюватиме?
 Перейти на ain.ua

Реклама
А Ви знаєте що на Платформі we.ua діє реферальна програма? Ви приводите друзів та знайомих і отримуєте винагороду за їх реєстрації.
То ж, не гайте час! Розкажіть про we.ua своїм друзям, родичам та колегам. Надішліть їм своє реферальне посилання, яке легко знайти в розділі Мої друзі, та отримайте на свій бонусний рахунок додаткові надходження за кожну нову реєстрацію.
Розміщуйте своє реферальне посилання в інших соціальних мережах, в коментарях, в тематичних форумах та будь-де. Так у Вас буде більше друзів та підписників і більше бонусів на бонусному рахунку.
Ви зможете використати бонуси на додаткові послуги Платформи, а також - придбати корисні товари в нашій online-крамничці.
Детальніше про реферальну програму: https://we.ua/info/referral-program.
 Дізнатись подробиці

12 Сер. 14:34 Технології
CyberCalmAnthropic позначатиме згенерований Claude контент невидимими водяними знаками
Компанія Anthropic почне вбудовувати невидимі водяні знаки у весь текст, який генерує її ШІ-асистент Claude, а до створених файлів додаватиме цифрово підписані метадані про походження. Так компанія виконує вимоги європейського Закону про штучний інтелект (EU AI Act), і позначення діятиме в усьому світі — незалежно від того, у якій країні перебуває користувач.
Що саме позначатиме Claude
Anthropic пояснює на сторінці підтримки, що моделі Claude, випущені в ЄС 2 серпня 2026 року або пізніше, підтримують машиночитане позначення від самого запуску. Згенерований текст нестиме вбудовані водяні знаки, а створені файли — цифрово підписані метадані про походження.
Позначення охоплює всі середовища, де використовується Claude: Claude Platform (API), застосунок Claude, Claude Code, Claude Cowork і Claude Tag. Воно діятиме й тоді, коли доступ до підтримуваних моделей здійснюється через хмарних партнерів — AWS, Google Cloud чи Microsoft Foundry. Для файлів позначка додається до підтримуваних форматів, зокрема SVG, PNG і JPG.
Для моделей, випущених до 2 серпня 2026 року, Закон передбачає перехідний період — Anthropic зазначає, що працює над додаванням підтримки позначення й для них.
Чому це відбувається: вимога Закону ЄС про штучний інтелект
Обовʼязок маркувати контент випливає зі статті 50 Закону ЄС про штучний інтелект. Її частина 2 вимагає, щоб постачальники генеративних систем ШІ позначали свій вихідний контент у машиночитаному форматі так, аби його можна було розпізнати як згенерований або змінений штучним інтелектом.
Ці вимоги набули чинності 2 серпня 2026 року. Аби спростити відповідність, Європейська комісія розробила Кодекс практики щодо прозорості згенерованого ШІ контенту, опублікований у червні 2026 року; станом на кінець липня його підписали близько 190 організацій. Закон має екстериторіальну дію: він поширюється на будь-якого постачальника, вихідний контент якого використовується в ЄС, незалежно від того, де зареєстрована компанія.
За даними Euronews, порушення вимог прозорості може коштувати компаніям до 15 мільйонів євро або 3% світового річного обороту — залежно від того, яка сума більша.
Як працює водяний знак у тексті
Коли підтримувана модель Claude генерує текст, вона вплітає непомітний водяний знак безпосередньо в сам текст. Знак не видно під час звичайного читання, і він не змінює зміст, якість чи читабельність відповіді. Оскільки водяний знак є частиною самого тексту, він зберігається, коли текст копіюють і вставляють в інше місце, і може вціліти навіть після певного редагування. Позначення застосовується на рівні моделі, тож воно присутнє незалежно від того, через який продукт Claude отримано текст.
Для файлів застосовується інший підхід: Claude додає цифрово підписані метадані за відкритим галузевим стандартом C2PA. Такі метадані фіксують, що файл обробив Claude, і дають змогу виявити, чи не був файл змінений після цього.
Позначка не завжди означає, що текст створив саме Claude
Anthropic окремо наголошує: наявність позначки свідчить лише про те, що контент міг бути опрацьований Claude, але не підтверджує авторства. Люди часто використовують Claude, щоб вичитати, перекласти, підсумувати чи конвертувати вже наявний матеріал — і результат отримає позначку, навіть якщо ідеї, текст чи дані походять з іншого джерела. Крім того, контент можуть змінити вже після обробки.
Працює це й у зворотний бік: відсутність позначки не гарантує, що текст не згенеровано ШІ. Позначки може не бути, якщо текст створила модель, випущена до впровадження маркування; якщо його суттєво відредагували, перефразували чи переклали; якщо фрагмент надто короткий для надійного сигналу; якщо метадані файлу видалили через конвертацію формату, повторне збереження чи знімок екрана; або якщо контент створено там, де певний тип позначення не підтримується.
Інструменти для виявлення позначок зʼявляться згодом
Anthropic повідомляє, що працює над тим, аби користувачі й треті сторони могли виявляти водяні знаки та метадані Claude. Технічні деталі про ці інструменти компанія обіцяє оприлюднити в подальшій документації.
Не лише Anthropic: маркування стає галузевою нормою
Anthropic — не єдина компанія, яка приєдналася до Кодексу. Наприкінці липня Meta підтвердила, що також підписує Кодекс практики щодо прозорості згенерованого ШІ контенту. Загалом, за даними Європейської комісії, до документа долучилися близько 190 організацій — від технологічних гігантів до невеликих стартапів. Утім, Anthropic стала однією з перших, хто детально описав власний механізм маркування саме тексту.
Для читачів це означає дві речі. По-перше, розпізнати текст, створений або опрацьований Claude, невдовзі стане помітно легше. По-друге, так само легше стане й іншим — виявити, що певний текст створено за допомогою Claude.
Часті питання
Що таке водяні знаки Claude?Це невидимі машиночитані позначки, які модель Claude вбудовує в згенерований текст, а до файлів додає у вигляді підписаних метаданих. Вони не змінюють зміст і потрібні, щоб контент можна було розпізнати як створений за допомогою ШІ.
Чи діють водяні знаки Claude лише в Європейському Союзі?Ні. Хоча вимога походить із Закону ЄС про штучний інтелект, Anthropic застосовує позначення в усьому світі — незалежно від того, у якій країні перебуває користувач.
Чи означає наявність позначки, що текст повністю написав Claude?Ні. Позначка свідчить лише про те, що контент міг бути опрацьований Claude. Її отримає й текст, який Claude лише вичитав, переклав або підсумував, тож ідеї можуть походити з іншого джерела.
Чи зникає водяний знак після копіювання чи редагування тексту?Під час копіювання й вставлення знак зберігається, бо є частиною самого тексту, і може вціліти після певного редагування. Проте суттєве переписування, переклад або надто короткий фрагмент можуть зробити його невиявним.
Як виявити водяний знак Claude?Anthropic працює над інструментами, які дадуть змогу користувачам і третім сторонам перевіряти текст і файли на наявність позначок Claude. Технічні деталі компанія обіцяє оприлюднити в подальшій документації.
Ця стаття Anthropic позначатиме згенерований Claude контент невидимими водяними знаками раніше була опублікована на сайті CyberCalm, її автор — Наталя Зарудня

12 Сер. 13:00 Війна та Оборона
Львів’янин Остап Коркуна у 2009 році поїхав працювати у Facebook. У компанії провів майже дев’ять років, будуючи інфраструктуру з нуля, коли ще не існувало навіть хмарних провайдерів. У 2014 році, коли почалась війна, Остап співзаснував благодійну організацію Nova Ukraine, яка дотепер займається гуманітарною допомогою Україні.
До 2024 року він працював директором інженерного напрямку в People.ai — українському стартапі, що згодом став єдинорогом у Кремнієвій долині. Компанію створив підприємець Олег Рогинський, який торік заснував deftech-компанію UFORCE, найвідомішим продуктом якої є морські дрони Magura. Рік тому разом із колишнім американським військовим Остап Коркуна заснував стартап NeoLens — ШІ-асистент для ремонту військової техніки.
Про те, як олімпіади відкрили йому шлях до Кремнієвої долини, яких людей шукає в команду свого стартапу й чому не приєднався до UFORCE (хоча такі розмови велися), Остап Коркуна розповідає в інтерв’ю DOU.
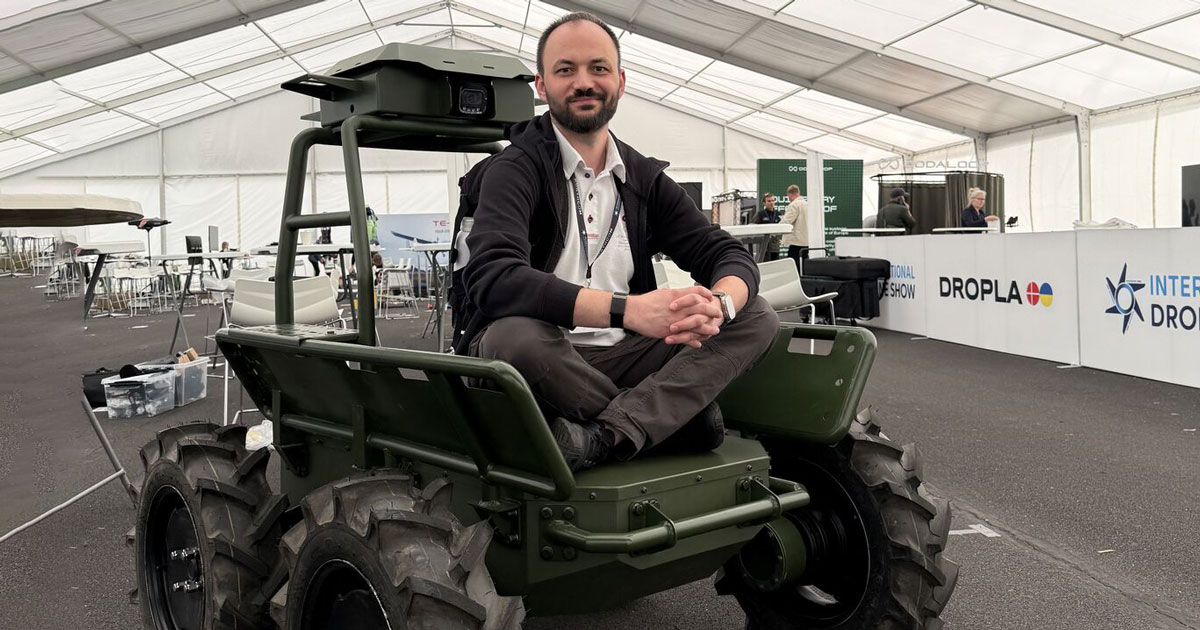
Остап на міжнародній виставці дронів у Данії
«Не виділяю окрему школу українських інженерів». Чим українські розробники відрізняються від американських
— Остапе, у 2009 році ви приїхали до Каліфорнії на запрошення компанії Facebook. Яким був технологічний ландшафт того часу?
Я був у когорті перших інженерів, яких Facebook найняв з-за кордону. Просто зі Львова прилетів у Пало-Альто (місто, де натоді базувалась штабквартира компанії — ред.). У Каліфорнії немає відчуття, ніби ти чужий. У топкомпаніях працює багато місцевих, але також тут завжди збирали таланти по світу. Усе залежить від того, як добре виконуєш свою роботу, а не від того, звідки ти.
Я пропрацював у Facebook майже дев’ять років: як інженер, потім як техлід. Спершу займався розробкою інфраструктурних систем. Коли я починав, ще не було ні AWS, ні хмарних провайдерів як таких. Кожна велика інфраструктурна система писалася з нуля всередині компанії.
Ми з командою писали системи, які зараз доступні у готовому вигляді в хмарі, а тоді їх треба було створювати з нуля. Це системи, які дозволяли всім сервісам працювати на тисячах серверів у датацентрах по всій країні, а згодом уже не тільки в США. Це надзвичайно цікава робота з інженерної точки зору. І, напевно, саме цей досвід залишається назавжди — через складність задач і через людей, з якими ти працюєш.
Facebook завжди збирав топінженерів, тож навколо були люди, у яких можна вчитися. Наприклад, ми стартували в одній когорті з Джеєм Паріхом, який тепер віцепрезидент Microsoft, і Андрієм Александреску, одним із піонерів С і творцем мови D. І це допомагає й зараз. Ті, хто починали інженерами разом зі мною, сьогодні обіймають керівні посади: хтось CТO, хтось на інших топпозиціях у великих компаніях. Це чудова мережа контактів і неймовірний досвід.
Світовий фінал ICPC у 2008 році
У мене досі зберігається давнє гасло компанії на постері з тих часів, коли я прийшов у Facebook: Move fast and break things. Зараз такої цінності в компанії немає, бо вона стала корпорацією. Коли я прийшов, у компанії працювало близько чотирьох сотень людей. Коли йшов, було вже 30 тисяч. А зараз, напевно, понад сотні тисяч.
Ця робота стала ключовою частиною моєї кар’єри. Мій підхід і моя філософія — намагатися, щоб кожен наступний крок спирався на фундамент, побудований попереднім досвідом.
У Facebook я потрапив завдяки тому, що ще студентом займався олімпіадами з програмування
Саме це дозволило компанії мене помітити, й завдяки цьому я зміг показати свої вміння та досить просто пройти інтерв’ю. Коли я їхав у Facebook, в Україні цим сервісом майже не користувалися. Ніхто не знав, чи компанія взагалі виживе. Був Google, і здавалося, що він буде завжди.
У фінансовому плані Facebook теж мені багато дав. Але за дев’ять років я, напевно, взяв усе, що міг узяти, і пішов шукати шлях далі.
Facebook, 2012 рік
— Як почуваються українці у Кремнієвій долині?
Колись вважалося, що існує сильна українська (чи, як дехто казав, радянська) наукова школа. Але хочеться бути прагматиком і реалістом. По-перше, я вважаю, що в кінцевому результаті все залежить від результатів і досягнень людини. Навіть у не дуже сприятливому оточенні людина може вирости в крутого спеціаліста, і навпаки.
Українська освіта загалом фокусується на точних науках. Пригадую, коли я виростав, була можливість глибоко вивчати математику, чим я й займався. Це означало перспективу стати науковцем. Але якщо згадати моє навчання в школі і в університеті, то всі практичні навички я отримав з власної ініціативи.
Ти не виходив з університету готовим спеціалістом: ні для західних компаній, ні для українських
Принаймні так було, коли я вчився. Тоді практично всі компанії працювали в аутсорсі, і кожна аутсорс-компанія мала власні курси підготовки для людей після університету чи під час навчання.
Тому якщо порівняти українців із колегами з американських університетів, то останні мали набагато більше практичних навичок одразу після навчання. Коли я потрапив у Facebook, я навіть MacBook не бачив, а Linux хіба кілька разів. Доводилось розбиратися на ходу. І я бачив інженерів, які приходили з американських університетів: вони чудово орієнтувалися в консолі, мали практичні навички відразу. Мені доводилося наздоганяти й переганяти. Але це мене драйвило.
Люди вчаться в середовищі, і українське навчальне середовище більш заточене на академічні навички. У робочому середовищі аутсорс диктував свої особливості. І коли я вже сам наймав людей в People.ai, у мене були складнощі з тим, щоб знайти людей, які мислять продуктово.
2015 рік
— У чому причини?
Я не вважаю це недоліком самого спеціаліста. Важко навчитися продуктовому мисленню, якщо ти не працюєш над продуктами, бо просто не знаєш, які є задачі. На мою думку, одна з найважливіших речей у продуктовому підході — це ownership: ти відповідальний за продукт у межах своєї компетенції і поза нею. Тобто йдеться про відповідальність за те, що продукт працює.
Тоді я спілкувався з інженерами й питав про їхній досвід, про системи, з якими вони працювали. Я питав, як усе функціонувало в продакшні. А вони цього не знали, бо не мали доступу до того, що відбувається з їхнім кодом після того, як вони його написали і протестували локально.
Для мене це була величезна прірва: робота людини закінчується в момент, коли вона віддала код. На жаль, такі стосунки замовників із аутсорсом були не рідкістю: ви, мовляв, пишете код, а дані ми вам не даємо, тестуємо самі.
Людина каже: «Я написав код, закомітив — готово, задача закрита». Але це не так, поки ти не перевірив усе вручну. Навіть якщо зробив гарні юніт-тести, але не переконався, що це працює, задача не закрита.
«Запит на сеньйор-інженерів величезний, а запиту на джуніор-інженерів практично немає»
— Чи змінюється статус Кремнієвої долини зараз?
У Долині всі чули про захмарні зарплати, якими OpenAI чи Anthropic переманюють інженерів. Запит саме на сеньйор-інженерів величезний, а запиту на джуніор-інженерів практично немає. AI-агенти сьогодні чудово пишуть код на рівні джуніор-інженера, а то й вищому. Але добре ухвалювати продуктові й архітектурні рішення агенти ще не навчилися (і, мабуть, не скоро навчаться).
Ситуація на ринку цікава, бо неможливо вийти з університету й одразу стати сеньйором. А набиратися досвіду стає складніше. Тож одні люди нарозхват, їх неможливо найняти, а інші не можуть знайти роботу. І ті, і ті — інженери.
— Що вам дав досвід роботи в People.ai? Один із засновників компанії Олег Рогинський зараз виготовляє ударні дрони Magura, чи не запрошував він вас приєднатися?
Олег звʼязався зі мною, коли почав набирати команду. Напевно, це свідчить про те, що я добре виконував свою роботу в People.ai. Цей досвід кардинально відрізнявся від того, що був у Facebook. Там я пропрацював майже дев’ять років, а це вже чимало за мірками Кремнієвої долини. Трохи виснажився, бо в Facebook завжди було інтенсивно. Водночас хотів шукати, чим хочу займатися далі. Усвідомив, що не зрозумію цього, поки не звільнюся. Тож я пішов і взяв перерву на кілька місяців. У цей час я почав консультувати MacPaw в Україні. Йшлося не про інженерні питання — їхні інженери краще розв’язували реальні проблеми у своєму технологічному середовищі, ніж це робив би я зі своєї фейсбук-бульбашки з її інфраструктурою й технологіями.
Але я міг допомогти з організаційними та менеджерськими питаннями, міг застосувати свій досвід побудови сильних інженерних команд. І цей короткий досвід консультування показав мені, що я можу мати хороший вплив як лідер і як менеджер.
У якийсь момент у мені прокинувся синдром самозванця: я консультував людей із менеджменту, їм усе подобалося, але я розумів, що жодного дня офіційно не працював як людина, відповідальна за інших людей. Моєю відповідальністю завжди була технологія. Я вирішив здобути цей лідерський і менеджерський досвід, щоб впевнено говорити про це. Було кілька різних варіантів: від маленьких компаній до великих, включно з варіантом повернутись у Facebook уже як менеджер. Я обрав найменшу компанію з тих, що пропонували мені цю роль. Розумів: із найменшою компанією ростиму найшвидше. Так у 2019 році, ще до буму ШІ, я потрапив у People.ai. Я прийшов туди як інженер, але з розумінням, що згодом перейду в менеджерську роль.
Лютий 2022 року
Я розбудовував одну з команд, які займалися ШI-розробкою, і зрештою став директором інженерів, відповідальним за напрям ШІ. Це був для мене класний менеджерський досвід, далеко не простий, зокрема тому, що якраз на цей час припав ковід. Почалося багато лейофів, які зачепили і мою команду.
Доти я працював в індустрії, яка мала практично необмежену кількість грошей і наймала всіх, кого тільки можливо. А тут вдарила реальність, де потрібно було ухвалювати рішення: хто залишиться в компанії, а з ким доведеться попрощатися, щоб вона вижила. Мене скорочення не торкнулося. Але, чесно кажучи, самому бути звільненим було б легше, ніж прощатися з людьми, яких так важко було набирати.
Це був цінний досвід роботи для мене. Я побачив, як працює стартап: нехай на пізній його стадії, та все ж. Я був набагато більш залучений, ніж коли прийшов у Facebook, де займався суто інженерною роботою.
З Олегом ми спілкувалися, коли він заходив у UFORCE і хотів побудувати сильну команду. Але натоді я вже працював над власним стартапом, тож у нас не було розмови про перехід, і я не отримував від Олега офер. Але мені було зрозуміло, чому ми взагалі говорили. Можливо, якби ми поспілкувалися на кілька місяців раніше, то зараз я розмовляв би з вами вже як один із лідерів компанії UFORCE.
— Чи помічаєте тренд, що топові інженери переходять в оборонний сектор, здобувши у бігтеху досвід, який допомагає створювати мілітарі-стартапи?
Не можу сказати, що в США є такий тренд. Тут видима інша тенденція: всі інвестори зараз зацікавлені в defense tech. Тільки не всі розуміють, що з цим робити, бо індустрія специфічна, і сфокусованих саме на оборонці фондів не так багато. Але всі фонди дивляться в цей бік і намагаються зрозуміти, як отримати хорошу позицію та позитивний результат у сфері оборонних технологій.
Якщо дивитися з позиції України, зрозуміло, чому всі хочуть займатися оборонкою. Але тут такого немає. США не ведуть війну. І якщо взяти пересічного американця (навіть того, хто вболіває за Україну), то для нього така підтримка — ідеологічна, але розбудова військової індустрії не є принциповою.
Шлях до стартапу: як працювати над військовою розробкою зі США
— З яких потреб виникла ідея стартапу?
Я навчався на магістерській програмі MSx у Стенфорді — це інтенсивний однорічний MBA для людей на середині кар’єрного шляху. Там познайомився з Джеймсом Лео — американським військовим, що народився на Тайвані і виріс у США. Він навчався у 10 класі, коли сталася атака 11 вересня. Джеймс покинув школу і записався в армію під впливом тих подій. Воював в Іраку, а потім повернувся, працював якийсь час у розвідці, а потім перейшов у приватний сектор: едтех та фінтехкомпанії. Джеймс став співзасновником стартапу, саме йому належить ідея NeoLens.
Остап і Джеймс, засновники стартапу
Ідея ґрунтувалася на розумінні проблеми операторів і механіків на передовій, які працюють із різною технікою і не завжди мають достатньо знань зі специфічним обладнанням. Джеймс із власного досвіду розумів: проблема є і стає тільки більшою, оскільки кількість техніки на одну людину збільшується.
Як і те, що ця проблема особливо гостра в Україні, де величезний зоопарк іноземної техніки далеко не першої свіжості. Разом ми пішли на курс Lean Launchpad, відомий саме в Стенфорді і в кількох інших університетах.
Там ми почали працювати над NeoLens. Ми проінтерв’ювали більше сотні українських і американських військових і виявили, що проблема є і в тих, і в тих. Один військовий розповів, що його підрозділ отримав броньовану машину MaxxPRO, але ніхто не знає, як нею користуватися, як навіть світло ввімкнути. Знайшли мануали, але вони англійською. Для американського військового обладнання це по кілька томів, по тисячі сторінок кожен.
Спершу ми не знали, над яким саме обладнанням будемо працювати, тож говорили з усіма. Спілкувалися з механіком, який ремонтує гаубиці. Йому потрібно було поремонтувати БТР М-113. Інструкцій немає, потрібна допомога. У нас мануалів теж не було, але почали шукати. За 24 години ми зробили перший прототип NeоLens — чатбота, що міг працювати тільки з М-113. Ми відправили його тому механіку. Ця версія була далекою від ідеалу, але все ж допомогла людині.
Згодом пройшли курс Hacking for Defense — спільну програму Стенфорда і Пентагону. Для нас зробили виняток, бо зазвичай команди працюють над задачами, поставленими Пентагоном, а ми прийшли зі своєю. Це дало доступ до американських військових напряму.
Ми їздили до штабу Центрального командування США, куди так просто не потрапити
Паралельно ми думали, як це впроваджувати в Україні. Фокус був одразу на Україну, але з глобальним позиціонуванням: ми розв’язуємо задачу, яка існує не тільки в defense tech, а всюди, де оператори мусять працювати зі складним обладнанням і де воно є дорогим.
Перший серйозний асистент для ремонту зробили для Humvee. Ігор Сімутін, він же доктор Хамер — топовий фахівець із цих позашляховиків в Україні. Він офіцер у силах логістики ЗСУ і створив чат для координації механіків і операторів приблизно на тисячу людей. Додав туди й мене, і я побачив проблему, яку ми намагалися розв’язати: хтось питає, чи можна змішувати рідини, хтось — за що відповідає датчик, хтось скаржиться, що щось капає. Відповіді є в мануалах, але вони не завжди під рукою, плюс мовний бар’єр.
Ми досягли цілі, хоч і не повністю замінили чат. Є багато запитань, на які ШІ не відповість: де найкращий шиномонтаж, де купити певну запчастину тощо. Але коли йдеться про запити, на які є відповіді в інструкціях, то часто відповідають саме посиланням на NeoLens.
Застосунок можуть використовувати оператори будь-якої техніки: від важкої броньованої машини до НРК, дронів тощо. За рік ми пройшли довгий шлях. Почали з того, що взяли доступні на той момент рішення у Cloud, які дозволяють завантажувати документи і робити по них пошук. По суті, побудувати чатбот, у якому можна простою мовою ставити прості запити. Використовували Pinecone. Але коли дали рішення спеціалістам, вони почали вказувати на місця, де відповіді неправильні. Ми копнули трохи глибше, зрозуміли, що правильну інформацію ці готові рішення знаходили десь у половині випадків.
Фото продукту
Технічна документація виявилась надто складною для обробки мовними моделями — вони губили семантику. Наприклад, якщо в документі була таблиця чи блоксхема, модель не розуміла, що чого стосується. Розділи ділилися неправильно: половина інформації залишалася доступною, половина — губилася. Так ми зрозуміли, що потрібне інше рішення.
Ми почали будувати свою систему retrieval. Але процесинг документів спочатку робили на платформі LlamaParse. Друга версія працювала вже краще, бо ми багато чого тестували й змінювали. Це був перший повноцінний асистент для Humvee, і обробка документів для нього зайняла більше місяця. Все працювало добре, але погано масштабувалося: довго, багато ручної роботи.
Тому зараз у нас повністю свій пайплайн для обробки документів. Беремо технічні документи, які мають складну семантику, і перетворюємо їх у формат, який легко розуміють мовні моделі. Так ми не покладаємось на внутрішні знання мовних моделей, тому наше рішення не галюцинує. Воно може працювати як із великими, так і з малими моделями. І саме завдяки цьому ми можемо зробити так, щоб рішення працювало офлайн на пристрої.
І про швидкість: зараз обробка документа відбувається автоматично й займає буквально кілька годин.
Без сумніву, є обмеження, бо онлайн-версія завжди працює краще, ніж офлайн: більші моделі можуть опрацьовувати більший обсяг інформації, ми можемо дати їм більше контексту. Наприклад, працюємо ми з ППО. Документація до одного типу обладнання може складатися з багатьох документів, включно зі старими радянськими, складними схемами тощо. І щоб просто відповісти на питання, потрібно опрацювати чимало контексту.
Малі моделі мають обмежений контекст, їм гірше вдаються логічні висновки. До того ж, щоб повноцінно запускати малі моделі, потрібен графічний прискорювач (GPU). Оскільки робимо це на телефоні, треба, щоб він мав графічний акселератор.
У нас є кілька рівнів підтримки офлайн-режиму: перший — повноцінний офлайн, що працює так само, як онлайн-режим, тільки з меншою моделлю. Є обмежені версії, які можуть відповідати на менший спектр питань. Зараз більшість наших користувачів користується онлайн-рішенням: воно дає кращу якість відповідей, і ним просто користуватися, навіть не потрібно встановлювати додаток. Це веб-застосунок, який працює прямо в браузері телефону.
Але повного паритету між онлайном і офлайном не буде ніколи. Щоб взагалі розв’язувати цю проблему офлайн, потрібно обробляти документи саме так, як ми це робимо. Немає моделі, яка може обробити на телефоні складну 1000-сторінкову PDF-ку.
— Яка команда працює над стартапом? Чи не важко робити це з Каліфорнії і чи є інженери в Україні?
У нас невелика команда, менше десятка людей. Але це топові фахівці: як з України, так і з Кремнієвої долини. Хлопці, яких я найняв в Україні, є учасниками фіналу чемпіонату світу з алгоритмічного програмування. Я сам був на фіналі один раз, а вони обоє — двічі. У Долині теж є своя спільнота олімпіадників. І хоча здається, що українців у Долині багато, всі активні люди між собою знайомі. Це фахівці, здатні розв’язати задачу, з якою мало хто може впоратися. І мені приємно, що я маю задачі, якими можу зацікавити цих людей, бо це спеціалісти, яким нескладно знайти роботу.
Разом зі мною є п’ятеро інженерів. Один із них — у Каліфорнії, решта тих, хто працює над продуктом, перебувають в Україні. Також в Україні колишній військовий Володя Гера допомагає нам зв’язуватися з військовими, надає підтримку, коли в Каліфорнії ніч. Головний наш фокус зараз — на ШІ-розробку. Є ще кілька людей, які займаються просуванням продукту на ринок. Я і Джеймс поєднуємо всі ролі.
Звісно, складно працювати у різних країнах і часових зонах, але намагаємося робити це якомога ефективніше. Зараз ми шукаємо людину в Україні, яка володіє стартап-філософією (чужих проблем не буває) і візьме на себе бізнес-девелопмент і маркетинг/sales, зосередиться саме на роботі з українськими компаніями і партнерами. Поки що я багато роблю сам.
— Чи часто українці в Каліфорнії долучаються до військових розробок?
Попри те, що галузь розвивається, це не так просто. У США долучитися до цієї індустрії набагато складніше, особливо якщо йдеться про оборонні компанії, що працюють в Україні, оскільки є експортні обмеження. Створити суто дефенс-компанію і впроваджувати свої продукти в Україні складно через ITAR (International Traffic in Arms Regulations, американські правила міжнародного обігу зброї — ред.), які не дозволяють експортувати військові розробки.
Ми під них не підпадаємо, бо в нас софтверна платформа, яка не є суто оборонною розробкою. Ті, хто робить військові розробки (хардвер, дрони чи системи наведення), підпадають під експортний контроль.
Багато українських компаній усе-таки починають в Україні, а потім роблять дочірню компанію в США. У нас навпаки: моя американська компанія має дочірню компанію в Україні.
Крім того, період від розробки до впровадження в Україні дуже короткий, на відміну від США, де рішення ухвалюють вкрай повільно. Тож розвивати дефенс-компанію можуть собі дозволити тільки люди з величезною фінансовою подушкою: власною або від інвесторів. Треба мати запас ходу на роки вперед. Немає такого, як в Україні, де компанія виготовляє хороший дрон і відразу виходить на прибутковість.
На міжнародній виставці озброєнь Eurosatory 2026 у Франції
— Як налагоджена ваша робота з виробниками?
В українських виробників дронів і НРК, які виготовляють тисячі одиниць обладнання на місяць, гостро стоїть питання підтримки. І наше завдання тут — бути зручнішими і ефективнішими, ніж телефонні оператори.
Перші, з ким ми почали працювати, — це компанія Roboneers. Вони виробляють НРК, турелі та дрони-розвідники. Це обладнання, яке живе відносно довго (не як FPV-дрон, який летить в один бік і все), хоча б кілька місяців, навіть в умовах бойових дій. І це потрібно обслуговувати.
Коли ми почали спілкуватися, проблема стояла так: коли в людей виникає будь-яке питання, ніхто не читає мануали, навіть хороші. У них є інструкції, є відеоуроки і так далі. Але людям легше набрати когось із компанії, ніж розбиратися самому. Це дуже відволікає працівників компанії.
Ми починали повністю на ентузіазмі. Приєднувалися люди, які мене знали і допомагали розробляти продукт. Коли прототип перейшов до реального продукту, потрібно було вже наймати інженерів. Затрат потребували й інфраструктурні рішення. Ми залучили ангельські інвестиції і за рахунок цього капіталу змогли довести продукт до рівня, на якому він є зараз.
Тепер виходимо на шляхи монетизації. Моя ціль — щоб цей продукт мав сталу історію. Ми не прагнемо отримати в Україні прибуток, а хочемо, щоб продукт працював, поки він потрібен військовим. Тому співпраця з виробниками у нас комерційна. Кожному виробнику, з яким спілкуюся, я кажу: якщо ми економимо вам гроші й час, тоді має сенс, що ви за це платите. Але військові користуються розробкою безкоштовно.
— Ви робите ставку на стартап чи плануєте також поєднувати з роботою у бігтеху?
Не думаю, що можливо ефективно займатися і тим, і іншим. Я вже працював над двома проєктами одночасно. Це був складний досвід, коли після 2022 року додалося багато роботи pro bono в гуманітарному проєкті Nova Ukraine. Це займало мінімум десять годин щодня. При цьому в мене була повноцінна робота, команда у People.ai, продуктивність якої залежала також від мене.
І так я працював два роки: робочий день фактично не завершувався
Моя ціль — зробити стартап сталим зокрема й для себе, не тільки через закладену в нього місію. Тож не думаю, що вийде ще десь працювати. Я цього не хочу. Хочу, щоб проєкт став успішною компанією як в Україні, так і на глобальному ринку. А для цього потрібен фокус.
Для мене надзвичайно важливе те, що ми робимо в Україні. Але водночас мені хочеться, щоб цей проєкт був значно більшим. Ми всі хочемо, щоб війна закінчилася, щоб Україна перемогла. Тоді застосовувати NeoLens можна буде не тільки у військовій сфері і не тільки в Україні. Його цінність стає все більшою, враховуючи те, куди рухається світ.
— Чи не сумуєте за часом, коли працювали в бігтеху?
Геть немає на це часу. Те, чим я займаюся зараз, є хорошим випробуванням. Це складна технічна задача, і нелегко з цього зробити успішний бізнес, який житиме далі. Десь я відчуваю відповідальність: я зробив те, чим користуються тисячі людей, і вважаю, що якщо не докладу всіх зусиль, щоб ця компанія стала успішною й прибутковою, то підведу і цих людей також.
Робота в Facebook була чудовим досвідом, але кожен досвід цінний у свій час. Я не з тих людей, які сумують за тим, що було колись, навпаки, будую цікаві задачі для себе зараз.
 Перейти на dou.ua
12 Сер. 00:34 Технології
Anthropic оголосила, що в нові моделі Claude вбудують у згенерований текст «невидиму водяну позначку». Подібну технологію вже використовує Google — система SynthID допомагає визначати контент, створений моделями компанії. Водяна позначка Anthropic не впливає на зміст чи читабельність тексту, зберігається під час копіювання та вставлення та може залишатися навіть після незначного редагування, повідомляє Business Insider.
Нововведення поширюється на весь контент, який Claude генерує в усьому світі, зокрема й під час використання моделі через хмарних провайдерів. Anthropic також планує надати стороннім розробникам інструменти, за допомогою яких можна буде виявляти такі мітки.
Технологію вже використовують у моделях Claude, випущених після 2 серпня 2026 року, а для старіших версій компанія планує додати її окремо. Система працює в Claude Platform (API), Claude Code і Claude Cowork, а також через хмарні сервіси AWS, Google Cloud і Microsoft Foundry.
Для файлів і зображень у форматах .png, .jpg та .svg передбачений інший механізм — криптографічно підписані метадані про походження контенту за відкритим стандартом C2PA (Coalition for Content Provenance and Authenticity).
Рішення Anthropic є частиною зобов’язань компанії щодо прозорості відповідно до Кодексу практики прозорості Регламенту ЄС про штучний інтелект (стаття 50(2) EU AI Act). Ці правила набули чинності 2 серпня 2026 року. Для моделей, випущених до цієї дати, передбачений чотиримісячний перехідний період — до 2 грудня 2026 року.
Однак система має обмеження. В Anthropic визнають, що глибоке перефразування, переклад, значне редагування або поєднання згенерованого тексту з іншим контентом можуть зробити позначку невиявною. До того ж, сама наявність позначки не означає, що Claude написав увесь текст. Вона може з’явитися навіть у разі, якщо модель використовували лише для вичитування, стилістичного редагування чи перекладу тексту, який спочатку написала людина.
ВАС ЗАЦІКАВИТЬ
Контент, створений ШІ, заполонив соцмережі: найбільше його виявили в LinkedIn
Це нововведення може мати важливе значення для видавничої галузі, яка останнім часом дедалі частіше стикається з підозрами щодо використання ШІ під час написання книжок.
Минулого місяця літературний агент відмовився представляти детективний роман «Call Me, I'll Hide the Body» Джеррі Фаладе після того, як виникли сумніви щодо використання штучного інтелекту під час його написання. Агентство заявило, що більше не може підтвердити, як саме створювався рукопис. Сам Фаладе заперечив, що використовував ШІ для написання книги.
Раніше цього року видавництво Hachette зняло з продажу роман жахів «Shy Girl» Мії Баллард після звинувачень у використанні ШІ. Баллард також заперечила, що писала книгу за допомогою штучного інтелекту. За її словами, фрилансер-редактор без її відома додав до тексту матеріал, створений ШІ.
Нова позначка Claude може стати додатковим інструментом для видавництв та навчальних закладів, які перевіряють, чи був текст створений за допомогою ШІ. Вона також може ускладнити видавання згенерованого штучним інтелектом тексту за власну роботу.
ВАС ЗАЦІКАВИТЬ
Штучний інтелект робить світ дурнішим — ЗМІ
Для України це також може мати значення, оскільки українське законодавство поступово наближається до норм ЄС. Відповідно, медіа і видавцям варто враховувати майбутні вимоги до прозорості контенту, зокрема використання водяних знаків і метаданих C2PA.Штучний інтелект уже створює значну частину текстів в інтернеті. За даними дослідження Graphite, 52% письмового контенту у мережі генерується ШІ. Автори дослідження простежили зміни з 2020 до 2025 року й зафіксували різкий стрибок після появи ChatGPT наприкінці 2022-го.
ШІ активно використовують і для створення новин. Ще у 2023 році повідомлялося, що понад 300 новинних сайтів публікували матеріали, створені штучним інтелектом. Деякі з них могли випускати до 1200 текстів на день. Тому для медіа та видавців, а також освітніх закладів дедалі важливішим стає питання, як визначити походження тексту.
 Перейти на zn.ua
11 Сер. 14:15 Технології
Anthropic маркуватиме контент, який створює Claude, за допомогою невидимих водяних знаків у тексті та цифрових метаданих у файлах. Про це компанія повідомила у своєму оновленому описі принципів маркування ШІ-контенту. Нові моделі Claude, запущені в ЄС 2 серпня 2026 року або пізніше, отримуватимуть підтримку машинозчитуваного маркування одразу після запуску. Anthropic працює також над додаванням таких позначок до моделей, які вийшли раніше. Як Claude маркуватиме контент Для тексту Claude використовуватиме невидимий водяний знак. Він вбудовуватиметься безпосередньо в текст і не має впливати на його зміст, якість чи читабельність. За задумом Anthropic, водяний знак зберігатиметься під час копіювання та вставлення тексту й може пережити деякі зміни. Для файлів підтримуваних форматів, зокрема .svg, .png та .jpg, Claude додаватиме підписані метадані про походження контенту. Вони базуватимуться на відкритому стандарті C2PA, який використовують для фіксації походження цифрового контенту. За наявності такого маркування можна буде перевірити, чи обробляв файл Claude і чи змінювали його після цього. Маркування поширюватиметься на підтримувані моделі та продукти Claude, зокрема Claude Platform (API), Claude, Claude Code, Claude Cowork і Claude Tag. Водяні знаки також працюватимуть під час доступу до моделей через AWS, Google Cloud і Microsoft Foundry, якщо відповідні функції це підтримують. Anthropic також планує надати користувачам і стороннім розробникам інструменти для виявлення таких позначок. Детальнішу технічну документацію компанія обіцяє опублікувати пізніше. Маркування не доводитиме, що весь контент створив ШІ Anthropic окремо наголошує на обмеженнях своєї системи. Виявлений водяний знак означатиме, що контент міг бути оброблений Claude, але не доводитиме, що саме Claude створив його з нуля. Наприклад, користувач може попросити Claude лише відредагувати, перекласти або скоротити текст, який спочатку написала людина. Такий результат теж може отримати маркування. Так само відсутність позначки не означатиме, що контент точно не створювався за допомогою ШІ. Маркування може зникнути після значного редагування, перефразування чи перекладу тексту. Для файлів метадані можуть бути втрачені після конвертації, повторного збереження або створення скриншота. Крім того, для дуже коротких текстів може бути недостатньо даних для надійного виявлення водяного знака. Хто ще впровадив подібні правила Серед компаній, які нещодавно оголосили про маркування ШІ-контенту, є Google. Зокрема, компанія почала показувати користувачам, чи була реклама створена або відредагована за допомогою штучного інтелекту. Інформацію про те, чи було рекламне оголошення згенероване за допомогою ШІ, можна переглянути, натиснувши на кнопку з трьома крапками або значок інформації біля рекламного оголошення. Якщо ж оголошення створене іншими ШІ-сервісами, рекламодавці повинні позначати його вручну. У деяких регіонах така позначка також може відображатися безпосередньо на самому рекламному оголошенні. Схожий механізм уже використовує Meta, яка показує позначку AI info в розділі About this ad. Ще у 2023 році компанії штучного інтелекту, зокрема OpenAI, Alphabet та платформи Meta взяли на себе добровільні зобов'язання перед Білим домом впровадити додавання водяних знаків до контенту, створеного штучним інтелектом. Більше про виявлення ШІ-контенту Інші платформи, на яких користувачі публікують контент, також запроваджували перевірку на ШІ та відповідні маркування. У травні 2026 року про нові заходи проти низькоякісного ШІ-контенту, автоматизованих коментарів і фейкових профілів оголосив LinkedIn. У компанії заявляли, що хочуть зберегти «реальні розмови» та видимість контенту від справжніх людей. Того ж місяця Американська академія кінематографічних мистецтв і наук також запровадила нові правила для премії «Оскар», які регулюють використання генеративного штучного інтелекту. Відтоді згенеровані ШІ актори та сценарії не мають права претендувати на нагороду. Крім цього, у червні музичний стримінг Deezer запустив безкоштовний інструмент, який дозволяє перевірити, чи є у плейлістах треки, створені штучним інтелектом. У компанії кажуть, що майже половина користувачів, які переходять на Deezer з інших сервісів, уже мають у своїх плейлістах ШІ-музику. Читайте також: «Цю статтю написала людина. Злякався, штучний інтелекте?» Як ШІ трансформував контент у медіа та соцмережах і чи вбʼє він поняття експертності
 Перейти на ain.ua
7 Сер. 16:51 Технології
Чатботи вже впливають на вибір товарів, але найбільша боротьба точиться за те, де саме покупець завершить замовлення.
Як зазначають Reuters
7 серпня 2026 року, Нью-Йорк – зростання використання чат‑ботів на базі штучного інтелекту для рекомендацій товарів підштовхує ритейлерів змагатися за появу в результатах чат‑ботів, водночас вони намагаються зберегти контроль над даними клієнтів, що підтримують онлайн‑продажі.
Зростаючий онлайн‑трафік із платформ штучного інтелекту спонукає таких гігантів, як Walmart, Ulta Beauty та Wayfair, оновлювати свої сайти, щоб їхні товари краще з’являлися в запитах чат‑ботів. Багато компаній хочуть, щоб покупки залишалися на їхніх сайтах, де вони можуть збирати дані про перегляди, обсяги корзини та попередні покупки, що допомагає формувати майбутні продажі та лояльність клієнтів.
За даними Juniper Research, цього року споживачі витрачатимуть близько 8 мільярдів доларів завдяки AI‑агентам, зокрема Anthropic’s Claude та Gemini, які перенаправляють їх на відповідні торгові майданчики. Adobe Analytics повідомляє, що 41% американських споживачів використали генеративний ІІ для онлайн‑покупок у червні, а відвідувачі, залучені через AI‑сервіси, принесли на 41% більше доходу за візит у порівнянні з тими, хто прийшов через традиційні канали.
На відміну від пошукових систем, які ранжують сторінки за ключовими словами та посиланнями, чат‑боти відповідають на детальні запитання, змушуючи ритейлерів переосмислювати опис товарів онлайн та шлях, яким користувачі знаходять бренди.
Ми завжди хочемо бути там, де перебуває наш гість. Чи то пошук у Google, афілійований маркетинг (або) Facebook – завжди існує податок за залучення клієнтів на чужих платформах. Я не думаю, що це інше.
– Josh Friedman
Ulta Beauty фіксує подвійний ефект конверсії: покупці, що потрапляють через Gemini та ChatGPT, демонструють вищий намір щодо купівлі. Компанія працює з Google над інтеграцією кошика та власної програми Ulta Beauty Rewards у AI‑покупки в Gemini, втім Фрідман підкреслює, що бажано завершувати транзакцію на сайті Ulta.
РОЗДІЛ: РИТЕЙЛЕРИ ЗАХИЩАЮТЬ СВОЮ ТЕРИТОРІЮ
Керівники ритейлу переконані, що вони зберігають перевагу, адже знають набагато більше про переваги клієнтів, ніж потужні інструменти загального призначення ІІ.
Коли покупець завершує покупку на сайті бренду, ритейлер підтримує прямі взаємини з цим клієнтом
– Vince Koh, глобальний керівник цифрової торгівлі AWS
AWS заохочує клієнтів‑ритейлерів, зокрема Kate Spade від Tapestry, використовувати AI‑платформи для маркетингу товарів, одночасно залишаючи власні сайти найкращим місцем для покупки.
Зокрема, коли на сайті Kate Spade шукають, скажімо, замшеві сумки за 380 доларів, компанія може використовувати дані про переглянуті товари, бюджети та стильові вподобання, щоб персоналізувати рекомендації та будувати лояльність, пояснює Koh.
Ритейлери мають більше знань про свої продукти та клієнтів, ніж загального призначення інструменти ШІ, що надає їм перевагу в рекомендаціях та лояльності.
Платформа для планування весіль The Knot також дотримується подібного підходу. Компанія оптимізує свій сайт так, щоб її постачальники з’являлися в результатах ChatGPT, але водночас намагається переконати пари бронювати весільні майданчики та запрошення безпосередньо через сайт компанії.
LLMs – це ще одне місце для старту, ще одне місце для пошуку, ще одне місце для планування, але у нас є три десятиліття даних, щоб допомогти людям координувати весілля
– Raina Moskowitz
Хоча ChatGPT та Gemini стають важливими каналами для маркетингу, споживачі все ще віддають перевагу завершенню покупок на сайтах ритейлерів.
У березні OpenAI припинила Instant Checkout – інструмент, що дозволяв покупцям купувати одяг та інші речі через ChatGPT. Компанія тепер зосереджується на розвитку відкриття товарів та допомозі продавцям і майданчикам, таким як Etsy, використовувати власні чекаути.
Etsy спостерігає подібну тенденцію: користувачі, які знаходять товари за допомогою ChatGPT, зазвичай повертаються на сайт Etsy, щоб завершити покупки, пояснює Рейф Колбурн, директор з продукту та технологій компанії.
Це початок глибших взаємин, а не лише відносин, що завжди опосередковуються ChatGPT
– Rafe Colburn
Попри зростання ролі штучного інтелекту, багато покупців все ще віддають перевагу завершенню покупки на сайтах ритейлерів, а не через сторонні інтерфейси, що підтверджує поточну тенденцію до збереження прямого зв’язку між брендом та клієнтом.
Інші теми, які вам можуть сподобатися:
Європейська Комісія розпочала антимонопольне розслідування проти Meta через обмеження використання AI-чатботів у WhatsApp, що може вплинути на конкуренцію в ЄС.
Onton, платформа з ШІ для онлайн-покупок меблів, залучила $7,5 млн для розширення в нові категорії товарів.
Malachyte залучила 10 мільйонів доларів на розвиток ШІ-платформи, яка персоналізує рекомендації в онлайн-магазинах у реальному часі.
The post Ритейлери перебудовують сайти, щоб потрапляти в рекомендації ШІ-чатботів first appeared on Межа. Новини України..
 Перейти на mezha.net
5 Сер. 17:21 Технології
Зростання попиту на Claude підштовхує компанію переглянути залежність від зовнішніх постачальників обчислювальної інфраструктури.
Як зазначає Techcrunch
Anthropic формує команду для розробки власних чіпів, призначених для використання в штучному інтелекті, повідомляють джерела в галузі. Компанія, яка створює Claude, заявила про намір спільно розробляти апаратне забезпечення та моделі, щоб її технології працювали швидше та ефективніше.
У попередніх обговореннях розглядалися Samsung як потенційний партнер для створення таких чіпів.
Рішення розробити власні чіпи з’являється на тлі зростання попиту на Claude, тоді як багато ІІ-компаній стискають угоди з постачальниками інфраструктури штучного інтелекту, щоб розширити свої можливості.
Зараз Anthropic уклала угоди з AWS, Google, Nvidia та AMD для доступу до апаратного обчислювального середовища, але для масштабування до рівня попиту цього може бути недостатньо.
Тенденції на ринку та приклади інших компаній
Не вперше ІІ-компанія обирає шлях створення власного чіпа: у червні OpenAI презентував чіп Jalapeño, розроблений Broadcom, який розрахований на завдання в режимі inference.
Google DeepMind давно використовує чипи TPU від Alphabet для своїх моделей штучного інтелекту, тоді як Meta розробляє власні прискорювачі MTIA для обробки ІІ-навантажень.
Anthropic шукає інженерів з досвідом у дизайні чипів для своєї «команди з розробки силікону на замовлення», згідно з оголошенням про вакансію.
Anthropic поки не відповіла на запит коментарів.
Цей крок підкреслює зростаючу конкуренцію в галузі штучного інтелекту та прагнення компаній мати більший контроль над своїми обчислювальними ресурсами, аби швидше та ефективніше обробляти інференс та навчання моделей.
Ще цікаві матеріали:
AISI зафіксував 19 несанкціонованих дій агентів Anthropic та OpenAI під час тестів кібербезпеки. Інциденти посилили вимоги до безпечного оцінювання автономних систем.
Samsung повідомила про рекордний прибуток у підрозділі пам’яті та очікує сильний попит на чіпи для ШІ цього року при обмеженій пропозиції, водночас мобільний бізнес зазнав збитків.
Anthropic може укласти шестирічну угоду з Volta на $10 млрд для забезпечення Claude обчислювальними потужностями та розвитку дата-центру в Норвегії.
The post Anthropic створює команду для розробки власних чіпів штучного інтелекту first appeared on Межа. Новини України..
 Перейти на mezha.net
Рішення ще не оприлюднили, але воно вже викликає занепокоєння у хмарних компаній і може змінити глобальний ринок постачання.
Як інформує Reuters
Вашингтон, 4 серпня. Адміністрація Трампа розробляє заборону на імпорт нових моделей китайських компонентів для дата-центрів, повідомляють кілька людей, знайомих із питанням. Йдеться про захист інфраструктури, яка підтримує розвиток штучного інтелекту.
Федеральна комісія з зв’язку (FCC), що регулює телекомунікаційну галузь, працює над нормою, яка заборонила б імпорт нових оптичних трансиверів, які дозволяють передавати дані через волоконно-оптичні кабелі в дата-центрах. Вона сподівається оприлюднити цю міру цього року, після чого вона набуде чинності.
За даними кількох осіб, знайомих із розробкою, ця міра має на меті запобігти крадіжкам даних, встановленню шкідливого ПЗ або порушенням обслуговування в американських дата-центрах, де зберігаються чипи для навчання та запуску моделей штучного інтелекту.
Трансивери безперечно становлять ризик. По мірі розгортання дата-центрів ви хочете переконатися, що ланцюг постачання дата-центрів безпечний з самого початку.
– Divyansh Kaushik
КИТАЙ ВІДПОВІСТЕ, ЯКЩО ПОТРІБНО: ПОСОЛЬСТВО
Білий дім та FCC не відповіли на запити про коментарі. Китайське посольство в Вашингтоні заявило, що Пекін закликає США «прислухатися до об’єктивних та раціональних голосів ділових кіл обох країн» і «припинити очорняти китайські компанії та погрожувати їм санкціями».
«Китай вживатиме всі необхідні заходи у відповідь на будь-яку дію, що завдає матеріальної шкоди його інтересам», – додало посольство.
У адміністрації США прагнуть уникнути повторної ситуації на кшталт Huawei, коли обладнання телекомунікацій, вироблене підсанкційованою китайською компанією, було настільки інтегроване в інфраструктуру країни, що його вилучення виявилось повільним, дорогим і складним.
FCC історично була незалежною владою, але у червні Верховний суд США підтримав звільнення члена Федеральної торговельної комісії від Демократичної партії на користь президента Дональда Трампа, розширивши його вплив на урядові регуляторні органи.
Зміни на кшталт заборони нових моделей китайських дата-центрівських пристроїв, ймовірно, торкнуться китайського виробника Zhongji Innolight (300308.SZ), одного з найбільших глобальних продавців трансиверів, який у червні був внесений до списку компаній, пов’язаних із військовою діяльністю Китаю. Такий список часто передвіщає більш жорстку політику. Innolight не відповів на запити про коментарі.
За можливих обмежень імпорту вони підвищать витрати американських хмарних компаній, таких як Amazon Web Services, оскільки може виникнути потреба переходу до інших виробників, зокрема Coherent та Lumentum, які з того часу могли б виграти від такого кроку.
Innolight має провідну 27% частку світового ринку трансиверів для дата-центрів, за даними Counterpoint Research. Coherent та Lumentum пропонують конкурентну технологію, але не мають достатнього масштабу, щоб повністю замінити китайських постачальників, повідомляє дослідження Foundation for American Innovation. Innolight отримує 90% доходів поза межами Китаю, згідно з висновками аналітичної доповіді.
AWS, Coherent та Lumentum не відповіли на запити про коментарі.
FCC раніше запроваджувала подібні обмеження щодо китайських дронів, маршрутизаторів, роботів та інверторів – спочатку про це повідомлялось вперше. У рамках нинішніх обмежень агентство може заборонити імпорт усіх нових моделей трансиверів, після чого звільнити багатьох неродових постачальників від обмежень.
Поки що Дональд Трамп у своїй другій каденції дотримується менш наполегливої позиції щодо Китаю після того, як Beijing використала експортні обмеження на рідкоземельні матеріали торік.
Підсумком стало те, що уряд продовжує шукати баланс між стримуванням китайських технологічних кроків і підтримкою американських компаній, на тлі зростаючих потреб у безпеці та контролі за критичною інфраструктурою. Змістовні рішення з цією темою залишаються в центрі уваги уряду та технологічної галузі, оскільки країна рухається далі у епоху штучного інтелекту та цифрової економіки.
Вас можуть зацікавити такі матеріали:
Ерін Брокович запустила інтерактивну карту дата-центрів США, зібрала майже 4 000 звернень і вимагає прозорості у процесах будівництва, що впливають на місцеві громади.
FCC заборонила продаж у США пристроїв із ключовими апаратними компонентами від китайських виробників, включно з Huawei і ZTE, через ризики для національної безпеки.
Керівник OpenAI Сем Альтман проведе закриту зустріч із топ-демократом сенатського Комітету з розвідки США, щоб обговорити регулювання ШІ, безпеку і прозорість алгоритмів.
The post Вашингтон готує заборону на нові китайські трансивери для дата-центрів first appeared on Межа. Новини України..
 Перейти на mezha.net
3 Сер. 23:57 Технології
Раніше Amazon оголосила про інвестицію до 25 мільярдів доларів у розробника штучного інтелекту Anthropic. Розширення співпраці у сфері ШІ та використання чипів Trainium посилюють позиції Amazon Web Services і підтримують зростання бізнесу. На цьому тлі ринкова вартість Amazon у понеділок уперше перевищила три трильйони доларів. Компанія стала п’ятою у світі після Apple, Microsoft, Alphabet і Nvidia, яка досягла такого показника. Про це повідомило інформаційне агентство Reuters.
Ринкова капіталізація Amazon у понеділок уперше перевищила три трильйони доларів. Зростання підтримав різкий підйом акцій після сильного квартального звіту. Інвестори також позитивно відреагували на ознаки того, що бум ШІ створює новий попит на хмарні обчислення. Саме цей напрямок залишається головним джерелом прибутку компанії.
Акції Amazon зросли приблизно на 5% і сягнули рекордних 285,01 долара. Від початку року вони додали понад 23%. Минулого тижня папери компанії показали найбільше одноденне зростання з квітня 2012 року. Це сталося після того, як Amazon повідомила про найшвидше зростання хмарного бізнесу за більш ніж чотири роки та підвищила прогноз річних капітальних витрат.
"Amazon, мабуть, є найбільш показовим прикладом економіки на цей момент. Він одночасно відображає споживчий попит і розвиток штучного інтелекту. Перед початком сезону звітності на ринку було багато сумнівів щодо того, що вони (гіперскейлери) відмовляться від витрат на штучний інтелект. Ми не отримали цього результату від Amazon та Microsoft, і це призвело до набагато ширшого позитивного сигналу для ринку", — сказав головний ринковий стратег Nationwide Марк Гекетт.
У понеділок подорожчали й акції інших гіперскейлерів. Microsoft зросла приблизно на 4%, Meta Platforms — на 6%, Alphabet — на 3,6%, а Oracle — на 5%. Інвестори продовжують оцінювати, які компанії здатні фінансувати масштабні інвестиції у ШІ без критичного погіршення грошових потоків.
Microsoft минулого тижня заявила, що залишатиметься генератором позитивного грошового потоку протягом 2027 фінансового року. Компанія також спрогнозувала капітальні витрати нижчими за очікування Волл-стріт. Це спричинило найбільше одноденне зростання її акцій із 2008 року.
Водночас Tesla і Alphabet завершили останній квартал із від’ємними грошовими потоками. Для Alphabet це сталося вперше. У Meta вільний грошовий потік скоротився на 91%, оскільки компанії продовжують вкладати мільярди доларів у розбудову інфраструктури для ШІ.
За словами Гекетта, ринок починає чіткіше розділяти переможців і тих, хто відстає серед так званої "Великої сімки" технологічних компаній. Раніше їх часто оцінювали майже як єдину групу. Після рухів минулого тижня інвестори стали більше дивитися на окремі результати кожної компанії. На його думку, це свідчить про повернення балансу на ринок.
Amazon стала п’ятою компанією, яка коли-небудь досягала ринкової вартості у три трильйони доларів. Раніше цей рівень долали Apple, Microsoft, Alphabet і Nvidia. Наразі Nvidia залишається найдорожчою компанією світу. Її ринкова капіталізація наближається до п’яти трильйонів доларів.
Amazon, яку Джефф Безос заснував у 1994 році, знадобилося трохи більше двох років, щоб додати ще один трильйон доларів до своєї ринкової вартості. Уперше оцінки у два трильйони доларів компанія досягла в червні 2024 року. Відтоді її акції підтримували сильні результати хмарного бізнесу та очікування подальшого зростання витрат на ШІ.
Amazon Web Services отримує вигоду від розширення партнерств із провідними компаніями галузі. Йдеться, зокрема, про угоди щодо хмарної інфраструктури та постачання чипів з OpenAI, Anthropic і Meta. Такі домовленості зміцнюють позиції AWS на ринку та збільшують попит на обчислювальні потужності Amazon.
ВАС ЗАЦІКАВИТЬ
Amazon уклала угоду з OpenAI на мільярдів: компанія повертає позиції у ШІ-перегонах
Нагадаємо, що Amazon також розширює використання ШІ у виробництві фільмів і серіалів студії Amazon MGM. Новий напрям очолив керівник розважального підрозділу компанії Альберт Ченг. Інструменти мають скоротити витрати, прискорити творчі процеси та забезпечити узгодженість персонажів між сценами. Amazon наголосила, що сценаристи, режисери, актори й дизайнери залишатимуться залученими до кожного етапу виробництва, а ШІ виконуватиме допоміжну роль.
 Перейти на zn.ua
Корпоративний ШІ виходить за межі експериментів: нова модель обіцяє компаніям контроль над власними даними, моделями та розгортанням застосунків.
Як вказує Techcrunch
Стартап Superblocks, що спеціалізується на vibe coding, уклав багаторічну угоду про спільний маркетинг з Amazon Web Services (AWS). Завдяки цій домовленості їхній інструмент може бути інтегрований прямо у приватні хмарні середовища клієнтів AWS.
Угода означає, що компанії на AWS з підпискою на Superblocks зможуть запропонувати vibe coding своїм бізнес‑користувачам, та ці застосунки не будуть передавати дані чи інформацію зовнішнім постачальникам моделей чи баз даних. Застосунки розгорнуть бази даних Amazon Aurora всередині приватної хмари компанії, а не створюватимуть зовнішні бази даних на кшталт Supabase.
Застосунки також інтегруватимуться з Amazon Bedrock – платформою AWS для розробки AI‑застосунків, шлюзом AI та інференсом. Фактично ці рішення опиратимуться підтримці та захисту IT‑відділу, а не стануть «крейзі‑прикладом» у корпоративному середовищі.
Сутність угоди та її вплив на корпоративні практики штучного інтелекту
TechCrunch повідомив, що співзасновник і CEO Superblocks Брэд Менезес описав vibe coding так:
Ми перенесемо це до ваших даних всередині вашого приватного хмарного середовища
– TechCrunch
AWS також допомагатиме продавати Superblocks підприємствам так само, як це робиться з багатьма партнерами в Marketplace. «Ми підтримуємо партнерів там, де бачимо сильний попит клієнтів і відповідність тому, як клієнти хочуть будувати свої рішення», – заявив представник AWS.
Хоч AWS наразі не має власного vibe‑coding агента для бізнес‑користувачів. Є Kiro – AI‑кодінговий агент для розробників, але він не є vibe‑кодером. Також у Amazon є помічник AI Quick для бізнес‑користувачів, але це радше схоже на Claude Cowork або Microsoft Copilot, ніж Lovable або Replit.
Цей крок може стати потужним імпульсом для Superblocks – компанії приблизно з 50 працівниками, яка станом на травень 2025 року залучила 60 мільйонів доларів у рамках раунду Series A за підтримки Spark Capital, Kleiner Perkins, Meritech Capital та Greenoaks.
Поза цим зсувом він символізує зростаючу тенденцію: гіганти хмарових сервісів заохочують корпоративних клієнтів розділяти власні моделі ШІ від іншого стеку інструментів і запускати їх на своїх хмарах. За відгуками вендорів, це дає підприємствам можливість обирати між моделями від різних провайдерів, зменшуючи залежність від одного джерела.
За даними, відкриті моделі становили 29% від загального трафіку через AI‑ворота Vercel минулого місяця – це підкреслює зростаючу роль багатомодельної стратегії для корпоративного використання штучного інтелекту й необхідність гібридної інфраструктури, де кодинг‑платформи працюють з різними моделями – від OpenAI та Anthropic до відкритих рішень.
Голову Microsoft Сатю Наделлу нещодавно підкреслювали подібні тенденції: важливо використовувати кілька моделей, щоб знизити витрати та уникнути уразливостей від прив’язки до одного постачальника. Такі позиції підкреслюють потребу мульти‑модельної екосистеми не лише для кодування, але й для обслуговування клієнтів, HR та продажів. Спостерігачі зазначають, що підприємства вже обирають Frontier‑моделі, зокрема китайські відкриті рішення, і цей тренд лише посилюється.
У контексті цього зростає значення таких ініціатив, як впровадження vibe coding у приватних, безпечних хмарах. Це може бути другою хвилею після впровадження агентів кодування для підприємницьких розробників. AWS підкреслює, що це Emerging category з реальним імпульсом для інновацій.
Якщо розглядати у довгостроковій перспективі, подібні партнерства можуть зробити приватні хмари більш привабливими для розгортання складних алгоритмів, з акцентом на безпеку, контроль та відповідність вимогам компаній. Зрештою, подібні ініціативи демонструють прагнення провайдерів хмарних сервісів запропонувати повний набір інструментів для AI‑гармонізації бізнес‑прискорення саме в рамках своїх платформ.
У підсумку зростаюча увага до vibe coding в приватних хмарах свідчить про більш обґрунтовану та багатогранну стратегію використання штучного інтелекту в бізнесі: від кодингу до обслуговування клієнтів та управління даними всередині корпоративних середовищ. Такі кроки AWS та інших гравців ринку можуть змінити ландшафт інтеграції ШІ у великі організації та створити нові можливості для стартапів на кшталт Superblocks.
У довгостроковій перспективі багатодрайверна модель розвитку ШІ може стати звичним інструментом для корпорацій, які шукають гнучкість у виборі моделей, контроль над даними та відповідність вимогам безпеки. І хоча конкретна реалізація vibe coding у приватних хмарах ще перебуває на ранніх етапах, інтерес до такої інтеграції зростає, що говорить про майбутнє, де компанії будуть самостійно керувати моделями та забезпечувати надійний захист даних у своїх приватних середовищах.
Схожі новини для вас:
Amazon підняв ринкову вартість близько на 300 мільярдів доларів після звіту про 37% зростання доходів AWS; інвестори оптимістичні щодо впливу інвестицій у ШІ, але вільний грошовий потік впав.
Шведський стартап Lovable веде переговори про залучення $300 млн при оцінці $13,2 млрд, що підкреслює зростаючий попит на інструменти для описової розробки (vibe coding).
Amazon інтегрував нові моделі OpenAI у платформу Bedrock, включно з Codex і Bedrock Managed Agents, після оновлення угоди OpenAI і Microsoft; це може прискорити впровадження агентивних рішень у хмарі.
The post Superblocks уклав угоду з AWS для запуску vibe coding у приватних хмарах first appeared on Межа. Новини України..
 Перейти на mezha.net
3 Сер. 18:49
Акції компанії зросли на тлі прискорення доходів хмарного підрозділу AWS у II кварталі
3 Сер. 18:31 Технології
Технологічний гігант додав трильйон доларів вартості трохи більше ніж за два роки, а інвестори побачили новий сигнал сили ШІ-буму.
Як зазначає Reuters
3 серпня 2026 року ринкова капіталізація Amazon вперше перевищила позначку в 3 трильйони доларів на тлі сильних фінансових результатів та сигналів, що бум штучного інтелекту підсилює попит на її хмарні сервіси – основний двигун прибутку.
Акції компанії на початку торгів зросли на 5,5% і торгувалися на рівні близько 286,20 долара за акцію, встановлюючи новий рекорд і підкреслюючи річний приріст понад 23%.
У п’ятницю акції Amazon підскочили на 15% після того, як компанія зафіксувала найшвидше зростання хмарних доходів за понад чотири роки та підвищила свій річний прогноз витрат на капітал.
Драйвери зростання та вплив на акції
Amazon і Microsoft – єдині дві з числа так званої Magnificent Seven, які витрати на ШІ окупилися в очах інвесторів. Tesla, Alphabet та Meta зазнали втрат, бо їхні великі плани витрат тиснули на вільний грошовий потік у попередньому кварталі.
Інвестиційна стратегія у ШІ та майбутні перспективи
Разом із іншими технологічними гігантами Amazon витрачає мільярди на розвиток ШІ-інфраструктури. У квітні компанія оголосила про нові інвестиції в Anthropic, а на початку року – про наміри інвестувати до 50 мільярдів доларів у OpenAI.
Зайняло трохи більше двох років після досягнення відмітки в 2 трильйони доларів у червні 2024 року, щоб додати ще один трильйон до вартості. Серед інших компаній, які раніше досягали позначки в 3 трильйони доларів, були Apple, Microsoft, Alphabet та Nvidia, причому Nvidia наразі є найбільшою світовою компанією за капіталізацією з близько 5 трильйонів доларів.
Погляд на майбутнє вказує на те, що активне розгортання технологій ШІ та хмарних сервісів залишатиметься ключовим імпульсом для Amazon, підтримуючи його позиції на глобальному технологічному ринку.
Рекомендуємо звернути увагу:
Nasdaq очолив зростання після 13,7% стрибка Amazon, але попередження Apple про проблеми з постачанням посилило волатильність і сумніви щодо інвестицій в ШІ.
Amazon оприлюднила кращі за очікування фінрезультати за другий квартал: продажі зросли на 20%, AWS додав 37%, капекс підвищено до 220 млрд доларів, акції відреагували зростанням.
Кібербезпековий стартап Horizon3 залучив $250 мільйонів у раунді Series E, досяг оцінки $2 мільярдів і розширює платформу NodeZero для автоматизованого тестування мереж.
The post Amazon уперше перевищила капіталізацію в 3 трильйони доларів на тлі буму ШІ first appeared on Межа. Новини України..
 Перейти на mezha.net
3 Сер. 11:20 Технології
У Головне управління розвідки наймають ІТ-спеціалістів. Умови для всіх вакансій — зарплата від $950, військова служба за контрактом або під час мобілізації, соціальні гарантії, можливості для навчання та професійного розвитку.
Додамо, що на кожну спеціалізацію можуть найняти по декілька фахівців. Також можуть подаватися ІТ-спеціалісти поза переліком опублікованих вакансій.
Ключові вимоги — громадянство України та відповідність вимогам для проходження військової служби.
Зазначимо, що через специфіку роботи ГУР, кандидати проходитимуть спецперевірку, яка триває близько пів року. Серед етапів такої перевірки: тестування на професійно-психологічну придатність і поліграф.
📌 Data Scientist/Machine Learning Engineer
Фахівець розроблятиме та впроваджуватиме ML-рішення для аналізу великих масивів даних, працюватиме з моделями прогнозування, класифікації, NLP та оптимізацією їхньої роботи.
Основні вимоги:
досвід роботи Data Scientist/ML Engineer від 2 років;впевнене володіння Python, PyTorch або TensorFlow;досвід роботи з алгоритмами машинного навчання та Big Data;знання NLP, статистики, теорії ймовірностей і математичної оптимізації;технічна освіта, англійська не нижче B2;
📌 Full Stack розробник (.NET Angular)
Спеціаліст розроблятиме та підтримуватиме програмне забезпечення, серверні застосунки на .NET, Web API та інтерфейси на Angular.
Основні вимоги:
досвід Full Stack-розробки від 3 років;знання C#, .NET 6 , ASP.NET Core, Angular, JavaScript/TypeScript;досвід роботи з MS SQL Server, PostgreSQL, Git;англійська від B2;
📌 Front-end розробник
Фахівець займатиметься розробкою та підтримкою фронтенд-застосунків, створенням інтерфейсів, тестуванням, рефакторингом коду та налаштуванням аналітики.
Основні вимоги:
досвід Front-end-розробки від 3 років;знання JavaScript і фреймворків Angular, React або Vue.js;досвід роботи з SQL, PostgreSQL, Docker і хмарними сервісами (AWS, Azure або Cloudflare);англійська від B2;
📌 Back-end розробник
Спеціаліст розроблятиме програмне забезпечення та системи збору й аналізу інформації, працюватиме над технологіями відновлення файлів і впровадженням нових технічних рішень.
Основні вимоги:
досвід розробки програмного забезпечення від 3 років;знання однієї з мов програмування (Java, Python, C/C , C#, Go, Rust, Kotlin, Swift, TypeScript та ін.);базові знання мережевих технологій, Docker, Bash/PowerShell/CMD;досвід роботи з хмарними сервісами (AWS, Azure або Cloudflare);англійська від B2;
📌 OSINT-аналітик
Аналітик займатиметься пошуком, перевіркою та аналізом інформації з відкритих джерел, а також готуватиме аналітичні матеріали та звіти.
Основні вимоги:
досвід в OSINT-аналітиці від 1 року;досвід роботи з Maltego, SpiderFoot, GHunt;вища освіта;аналітичне мислення та уважність;досвід журналістських розслідувань буде перевагою;громадянство України та відповідність вимогам для проходження військової служби.
📌 Менеджер з комунікацій/SMM Lead
Фахівець відповідатиме за SMM-стратегію, координацію створення контенту, ведення соцмереж і сайту, а також аналіз ефективності комунікацій.
Основні вимоги:
досвід у SMM або digital-комунікаціях від 2 років;впевнене володіння Meta Business Suite, Figma та Microsoft Office;досвід планування контенту й координації роботи команди;англійська від B2;громадянство України та відповідність вимогам для проходження військової служби.
📌 Android-розробник
Спеціаліст розроблятиме та підтримуватиме Android-застосунки, оптимізуватиме їхню продуктивність, працюватиме з Android SDK, API та системними компонентами.
Основні вимоги:
досвід Android-розробки від 1 року;знання Kotlin або Java (Flutter/Dart буде перевагою);досвід роботи з Android SDK, Jetpack, API;розуміння архітектур MVVM і Clean Architecture;англійська від B1;громадянство України та відповідність вимогам для проходження військової служби.
Щоб відгукнутися на вакансії, треба заповніти анкету на сайті ГУР. У розділі «Бажаний вид діяльності» обрати «Допоміжні підрозділи», а далі назву вакансії. Наприкінці анкети треба додати своє резюме, а в полі про мотивацію за бажанням зазначити, що знайшли вакансію на DOU.
 Перейти на dou.ua
Приєднуйтесь до Платформи
 Український тиждень1.3 тис новин
 Суспільне82.4 тис новин
 Texty.org.ua1.9 тис новин
 Слово і Діло3.5 тис новин
 Укрінформ56.4 тис новин
 Лівий берег35.7 тис новин
 Дзеркало Тижня22.1 тис новин
 Бабель8.6 тис новин
 Громадське радіо8.6 тис новин
 Радіо Свобода16.3 тис новин
 Українська правда25.2 тис новин
 Еспресо21.6 тис новин
 New Voice77.3 тис новин
 Прямий канал6.2 тис новин
Останні коментарі
 Польські посадовці обурилися комунікацією Володимира Зеленського щодо ракет для Patriot
 Болгарія погрожує заблокувати 21-й пакет санкцій ЄС проти РФ, якщо з нього не приберуть главу РПЦ Кирила та співзасновника "Лукойла"
 Vitalii3 Лип. 20:02В політиці шлюхи не переведуться ніколи.
- Двоетапна перевірка у месенджерах: як налаштувати WhatsApp, Telegram, Signal, Viber і Messenger
- Росія завдала ракетно-дронового удару по Україні, ППО збило 82 безпілотники
 Білорусь втратила частину можливостей допомагати рф атакувати Україну - ЛещенкоVitalii27 Чер. 21:22Хтось ще слухає що каще СерЛещ?!
 Механіки застерігають від купівлі цих дорогих автомобілів
 samohodbox.com.ua22 Чер. 16:26Найбільша проблема дорогих автомобілів починається не з купівлі, а з першого серйозного ремонту.На практиці власники часто стикаються не лише з високою вартістю робіт, а й з пошуком правильних запчастин. Особливо коли мова йде про Range Rover, Mercedes-Benz, BMW або Porsche.Саме тому перед покупкою будь-якого преміального авто варто заздалегідь перевірити доступність та вартість основних вузлів і запчастин. Багато корисної інформації про OEM-номери та підбір деталей можна знайти на SamohodBox.Надійність автомобіля — це не лише бренд на капоті, а й вартість його утримання.
 Голова Пентагону вперше за тривалий час прибув на міністерський саміт НАТО: не стримувався у критиці союзників та зробив заяви щодо України – подробиці (Відео)Vitalii18 Чер. 17:19When morons are in charge of the USA. :(
- Центр протидії дезінформації викрив російську кінопропаганду як системну загрозу
 Українців попередили про штрафи за камуфляж: коли «піксель» може стати проблемою
 Нейт9 Тра. 14:09Військова і вважаю що носіння форми цивілами це аморально, для мене це на рівні як начепити чужі ордени (ну тобто тіпа приписуєш собі заслуги і досягнення яких ніколи не мав). Виняток - тактичний одяг у волонтерів, вони хоч і не воюють але роблять для перемоги не менше. Ну тобто або працюй на перемогу або не допускай щоб про тебе думали що ти працюєш на перемогу коли це не так
- Втрати військ рф перевищують їхнє поповнення - Жмайло
- СБУ розслідує вербування «злодієм в законі» мешканців Львівщини для роботи на спецслужби РФ
 Музей збройних сил у німецькому Кобленці заборонив українцям відвідувати експозицію
 Ihor Chaban14 Кві. 16:13Бояться що би що???😅
- Угорці обрали свободу, це добра новина для України і Європи - Мерц
- На Закарпатті озброєний чоловік викрав жінку з дитиною, при спробі затримання стріляв у поліцейськогоIhor Chaban14 Кві. 15:59Ужас, народ божеволіє!
 «Сяйво» обходить конкурентів: Українці обрали назву національної LLM
 Alexander30 Бер. 21:47Це просто крінж
- Для важкої роботи. Renault планує запустити 350 людиноподібних роботів на своїх заводахIhor Chaban25 Бер. 13:25350 людей залишуться без роботи! жесть!
- Передача МіГ-29 Україні була хибним рішенням – президент Словаччини
 SR-Team8 Лют. 10:58цитата-Жодна інша країна не вчинила так, щоб після передачі власного озброєння стала покладатися виключно на допомогу своїх сусідів", хочу нагадати ,а Україна за Будапештом як позбулася своєї зброї ,ядерної,літаків ТУ-160 ,теж надіялась на так звані "гарантії" !Щось слабонькі у нас дипломати ,не вміють 'дипломатично"по морді врізати!!!
 Військові показали, як нині виглядає Куп'янськ
 Підтримка (Support)30 Гру. 2025 15:48Сумно ((
- Зеленський обговорив з Мерцом підготовку до зустрічі з Трампом
 Леонід Биков26 Гру. 2025 19:45Балакай не балакай, а путлєр на своїй хвилі...
- Російські спецслужби вербують агентів через TelegramНейт1 Гру. 2025 06:35особисто стикалась ще з іншими методами, військова але думаю цивіли теж можуть зіткнутись з чимось схожим. коли десь в публічних чатах пишеш про свої проблеми (думаю особливо коли це невдоволення своїм командуванням, невдоволення владою або невдоволення роботою правоохоронних органів) то в особисті пишуть люди які тіпа тебе підтримують, більшість наші і пишуть щиро але серед них є і русня. так от з тих хто мені писав один одразу почав з того що він кацап і пропонує перейти до них, звісно одразу послала і заблокувала. а другий довго прикидався нашим (можливо навіть з окупації) і його видавало тільки те що якось надміру цікавили такі речі як де я, де мій підрозділ, скільки нас тут і так далі.. звісно я йому ніхєра не казала і теж залокувала але по факту він тупо намагався маніпулювати і цілком можливо що є лохи які через брак досвіду через отаких от нахаляву нададуть кацапам інфу самі того не розуміючи. самим цим ситуаціям мабуть більше року але можливо кацапи продовжать отак вишукувати людей у яких є певні проблеми які в теорії можуть зробити їх вразливими до маніпуляцій, при тому деякі все ж вміють прикидатися своїми тому все шо нам залишається це звертати увагу на підозрілі моменти типу надмірної цікавості і не довіряти нікому
 Ранкова звичка, яка підсилює мозок і допомагає отримати підвищення — що показало дослідження
 Village UA23 Лис. 2025 23:52пити каву?
- Небезпечна рослина сусіда почала "захоплювати" чужий двір: відео вразило МережуVillage UA22 Лис. 2025 11:19кропива?
- Топ-7 собак, які ніколи не втомлюються: породи для по-справжньому активних сімейVillage UA22 Лис. 2025 11:14там 100% є хаскі)
- Трамп зробив гучну заяву про втрату Україною територійVillage UA22 Лис. 2025 11:12голодний дєдок, вже мікрофон жере)
- Яка зброя реально змінить ситуацію на фронті: експерт відповівVillage UA21 Лис. 2025 18:55якісна)
- Трамп оголосив дедлайн для погодження Україною мирного плануVillage UA21 Лис. 2025 18:54трамп гнилий дєд, який постійно забуває випити таблетки)
- Анджеліна Джолі в ТЦК: Мережа вибухнула мемамиVillage UA5 Лис. 2025 22:22такі новини мені подобаються!
- Орбан розкритикував "невдячність" Києва за підтримку від УгорщиниVillage UA4 Лис. 2025 23:02коли його вже викинуть у вікно?
- Квіти, що захищають оселю від зла й негативуVillage UA4 Лис. 2025 19:00валерянка?
 Фіналісти конкурсу кумедних фото природи 2025 — коли переможець неважливий
 Miro Baida3 Лис. 2025 19:22Дійсно хороша новина
- Чому не можна віджимати пакетик чаю: багато хто не знаєVillage UA2 Лис. 2025 13:56в кого?
- Новорічний зворотний відлік: скільки днів до зустрічі 2026 рокуVillage UA1 Лис. 2025 12:10а хто зустрічатись має?
- Розвідка США розкрила несподівані постачання для війни РФ: що приховують Китай і МоскваVillage UA30 Жов. 2025 11:57моцква пишеться з маленької)
- Туск розніс Орбана: лідер найбіднішої країни в ЄС "зачарований Москвою"Village UA28 Жов. 2025 21:44фото супер!🤣
- Навіщо досвідчені господарі залишають кореневища від капусти після збору врожаю на городіVillage UA24 Жов. 2025 14:14щоб поламати об них ноги.
- Зеленський прибув з візитом до Лондона: з ким зустрінеться президент УкраїниVillage UA24 Жов. 2025 14:13з кимось)
- Росія створила фейковий Telegram, який стежить за користувачами — ЦПДПідтримка (Support)21 Жов. 2025 23:33А оригінальний тоді що робив? ))
- Рада продовжила воєнний стан і мобілізацію, а Бережну призначили міністеркою культури. Головне за день
 Лютий Махновець21 Жов. 2025 22:12"міністерка"?... а якби чоловік, то - "мініструк"?...