Тренд пошуку "Grok"
Стрічка оновлень
Коментарі
ІМІ рекомендує
12°
13 жовтняпентагонвінницязапоріжжяфутболісткімберлі гілфойлновини вінниціукраїнасергій лавровзміни в бронюваннітанкермхпнаціональний банк україниавтобусбронюванняновини закарпаттялівий берег – зоряуказ президента україниюлія стародубцевапротиповітряна оборонареферендуміндекс інфляціїхвилина мовчаннястів віткоффсніданокальтернатива для німеччининафтоналивний терміналлнз – кудрівкаukr.netксенія мішинаЩе..

1 Вер. 17:29 Технології
Росія продовжує системно атакувати великі склади поблизу Києва. Уже було уражено хаби великих продовольчих мереж. Чи зможе ворог атаками заблокувати постачання продуктів у Київ - штучний інтелект дав обнадійливу відповідь.Що каже ChatGPTЧат-бот вважає, що головна загроза для столиці - не знищення самих запасів, а порушення доставки продуктів до магазинів. Якщо під ударами опинятимуться великі склади, транспортні вузли та залізниця, бізнесу доведеться розосереджувати запаси, використовувати менші майданчики й шукати нові маршрути. Це неминуче призведе до здорожчання логістики.Водночас, за оцінкою ChatGPT, Київ радше зіткнеться з нестабільним постачанням, ніж із повним зникненням продуктів. Окремі товари можуть тимчасово зникати з полиць, а ціни - зростати.Найгіршим буде одночасний удар по енергетиці, дорогах і залізниці. Саме така комбінація, на думку чат-бота, здатна створити серйозну продовольчу кризу.Що прогнозує GeminiМодель ШІ також не бачить реалістичного сценарію, за якого Київ можна повністю відрізати від продовольства ударами по складах.Чат-бот звертає увагу на здатність торговельних мереж швидко перебудовуватися. Серед можливих варіантів - прямі поставки від виробників, використання регіональних хабів і доставка безпосередньо до магазинів.Тому наслідком атак, за оцінкою Gemini, стануть передусім вищі витрати на перевезення, скорочення асортименту та тиск на ціни. А от справжній дефіцит їжі у столиці створити буде значно складніше.Що думає GrokЧат-бот також відповів категорично: повністю перекрити постачання продуктів до Києва Росія не зможе. Зазначив, що навіть знищення близько 90% великих розподільчих складів торговельних мереж, яке він закладає у свій сценарій, не означатиме краху системи.На його думку, бізнес переходить на дрібніші склади, прямі поставки та доставку “з коліс”. Продукти в Україні залишаються, тому основними наслідками стануть перебої, дорожча логістика та зростання цін.Що кажуть усі три чат-ботиУ головному прогнози збігаються: повністю перекрити Київ від продовольства ударами по складах і логістичних об'єктах Росії буде дуже складно.Різниця - в акцентах. ChatGPT найбільше наголошує на небезпеці одночасного удару по енергетиці, дорогах і залізниці. Gemini робить ставку на гнучкість ритейлу та альтернативні канали доставки. Grok - на децентралізацію складів і прямі поставки.Отже, реальніший сценарій - не голод у Києві, а дорожчі продукти, менший вибір і тимчасові провали в постачанні.Нагадаємо: портал “Коментарі” писав, який сценарій загрожує Києву восени.
 Перейти на society.comments.ua
1 Вер. 15:04 Війна та Оборона
Керівник Офісу президента Кирило Буданов зазначив, що РФ буде тероризувати Київ та область постійними атаками реактивних дронів до виборів у Держдуму - до 18-20 вересня. Портал “Коментарі” запитав у штучного інтелекту, чи дійсно Росія припинить масований та цілодобовий терор Києва та області.Чат-бот ChatGPT переконаний, що слова Буданова варто сприймати не як точну дату завершення атак, а як мінімальний горизонт, до якого Росія може зберігати нинішню інтенсивність.Модель ШІ зазначає, якщо Кремль справді поставив собі завдання створити “картинку перемоги”, то різкого припинення атак одразу після виборів очікувати не варто. Швидше за все, до середини вересня Київ і область залишатимуться під підвищеною загрозою, а далі характер ударів може змінитися: менше безперервних хвиль, але періодичні масовані нальоти цілком можливі. Водночас Україна вже працює над контрзаходами проти швидкісних дронів, тому для РФ це не гарантовано довгострокова перевага.Прогноз чат-бота - найважчими можуть бути найближчі два-три тижні, але 20 вересня не стане автоматичним “кінцем терору”. Росія здатна продовжувати атаки доти, доки вважатиме їх ефективними для виснаження ППО, залякування людей і тиску на Київ.Чат-бот Gemini зазначає, що для Кремля масовані нальоти швидкісних реактивних безпілотників - це не просто спроба виснажити українські сили ППО чи пошкодити інфраструктуру, а й елемент внутрішньополітичного шоу. Російській пропаганді критично важливо демонструвати власному населенню удавану “силу” та ілюзію домінування на тлі посилення воєнно-економічного тиску.Проте модель ШІ попереджає, що сподіватися на магічне завершення терору одразу після 20 вересня, навряд чи варто. Росія робить ставку на дешевизну та відносну ефективність масового застосування безпілотників, тому атаки на Київ та область триватимуть стільки, скільки у ворога вистачатиме компонентів і накопичених ресурсів. Дати виборів можуть бути лише піком чергової ескалації, після якого інтенсивність тимчасово спаде через виснаження накопичених запасів, але самі нальоти залишатимуться постійним фактором тиску.Головний запобіжник від цього терору - це активне знищення майданчиків запуску й виробничих потужностей ворога. Чат-бот Grok переконаний, що інтенсивність саме такої, майже цілодобової, серії атак, за прогнозом чат-бота, справді спаде після виборів. Можливо, ще тиждень-два після 20-го числа будуть дотискати, щоб “ефект” не зник одразу. Але повністю зупинятись вони не будуть. Реактивні дрони вже стали їхнім основним інструментом - дешевше за ракети, складніше збивати, і психологічно дуже виснажують. Тож окремі нальоти, хвилі по 50-100 штук продовжаться і в жовтні, і далі. Просто не такими щільними пачками день за днем.За прогнозом моделі ШІ, конкретний “терор без пауз” триватиме ще два-три тижні максимум. А взагалі як інструмент - поки є виробництво і поки ми не навчимося збивати їх ефективніше. На жаль, це надовго. Головне - далі зміцнювати ППО.Усі три моделі ШІ сходяться в головному: 20 вересня навряд чи стане датою завершення російського терору Києва та області. Найімовірніше, саме найближчі два-три тижні можуть залишатися періодом найвищої інтенсивності атак. Після виборів у РФ частота ударів, ймовірно, дещо знизиться, але повністю вони не припиняться. Реактивні дрони залишаються для Росії відносно дешевим інструментом масованих атак, тому окремі хвилі можуть продовжуватися і в жовтні, і надалі - поки Росія зможе виробляти ці дрони.Нагадаємо: портал “Коментарі” писав, куди ховатимуться нардепи від атаки дронів.
 Перейти на society.comments.ua

1 Вер. 11:02 Війна та Оборона
Пентагон додав спеціальні версії ChatGPT і Grok до захищеного порталу GenAI.mil. Доступ до ШІ-інструментів отримали близько 3 млн військових і цивільних працівників Міноборони США.
 Перейти на techno.nv.ua

1 Вер. 09:23 Технології
Пентагон запустив спеціальні версії ChatGPT і Grok, адаптовані для потреб американських військових та державних службовців. Нові AI-інструменти вже стали частиною захищеної платформи GenAI.mil, де раніше був доступний Google Gemini. Загалом користуватися системою зможуть близько 3 мільйонів військових і цивільних працівників.
Версія OpenAI отримала назву ChatGPT Mil, а варіант від xAI – Grok for Government. Компанії спеціально адаптували свої моделі для роботи з державними та військовими завданнями. При цьому йдеться про використання в середовищі, де потрібні додаткові заходи безпеки та контроль доступу до даних.
Усі ці інструменти об’єднані на платформі GenAI.mil, яка має стати єдиним місцем доступу до різних AI-систем. Пентагон таким чином хоче прискорити використання штучного інтелекту у своїй роботі, дозволивши співробітникам обирати відповідний інструмент залежно від конкретного завдання.
Цікаво, що до ChatGPT і Grok у системі вже був присутній Google Gemini. Таким чином, американське оборонне відомство фактично створює власне середовище з одразу кількома провідними AI-моделями. Це дозволяє не залежати від одного постачальника та порівнювати можливості різних систем.
Поява таких сервісів показує, наскільки швидко штучний інтелект стає частиною державного сектору США. Ще кілька років тому подібні чат-боти сприймалися переважно як споживчі продукти, а тепер їх спеціальні версії використовуватимуться в масштабах одного з найбільших державних відомств країни.
Запис Пентагон отримав власні версії ChatGPT і Grok спершу з'явиться на iTechua - Новини про смартфони, гаджети і різні девайси.

1 Вер. 09:14 Технології
Міністерство війни США запустило спеціальні військові версії ChatGPT від OpenAI та Grok від xAI для цивільних і військових співробітників після того, як уклало спеціальні угоди з компаніями. Нові інструменти стали частиною захищеного порталу GenAI.mil, який покликаний забезпечити доступ до сучасних моделей штучного інтелекту без ризику витоку конфіденційних урядових даних. Платформа вже налічує понад 1,7 мільйона користувачів із трьох мільйонів працівників відомства, передає TechCrunch.
ChatGPT Mil і Grok for Government стали новими сервісами порталу GenAI.mil, який Пентагон запустив минулого року. На старті платформа пропонувала доступ до Google Gemini, а тепер розширила перелік доступних моделей генеративного ШІ. Окрім OpenAI та xAI, Міністерство війни США співпрацює з Amazon Web Services, Microsoft, Nvidia та Reflection AI.
Головною особливістю порталу є робота через захищену інфраструктуру Міністерства війни. На відміну від звичайних споживчих сервісів, військові версії не передбачають збору даних користувачів у форматі, характерному для комерційних продуктів. У Пентагоні заявили, що інтеграція нових моделей є частиною ширшої стратегії використання ШІ для прискорення роботи відомства без шкоди для безпеки.
ВАС ЗАЦІКАВИТЬ
Пентагон закликає розробників ШІ прибрати запобіжники для військових цілей — Reuters
ChatGPT Mil створено в межах програми OpenAI for Government і він зберігає звичний інтерфейс комерційної версії ChatGPT. Система підтримує чати, роботу з файлами та проєктами, використання спеціалізованих моделей і виконання адміністративних завдань, логістичного планування та підготовки документів, які не потребують допуску до державної таємниці. У Міністерстві війни зазначили, що згодом функціональність ChatGPT Mil розширюватиметься.
Для Grok for Government Пентагон передбачає ширше застосування у військовій сфері. Система працює на базі Starshield AI від SpaceX — захищеної супутникової мережі, створеної на основі технологій Starlink.
У відомстві заявили, що Grok забезпечить військовослужбовцям “миттєве підвищення продуктивності, краще засвоєння знань, а також безпечнішу й ефективнішу співпрацю”. Також очікується, що система допоможе “швидше й точніше виконувати завдання в різноманітних операційних сферах: від аналізу ринку для фахівців із закупівель до управління ланцюгами постачання для логістів”.
Водночас серед доступних моделей відсутня Claude від Anthropic, що відображає тривалий конфлікт між компанією та Пентагоном. Адміністрація президента США Дональда Трампа раніше визнала Anthropic ризиком для ланцюга постачання після того, як компанія відмовилася надати необмежений доступ до своїх інструментів ШІ без додаткових заходів безпеки. Нещодавно суд визнав незаконними дії Міністерства війни щодо компанії Anthropic.
 Перейти на zn.ua

31 Сер. 13:26 Технології
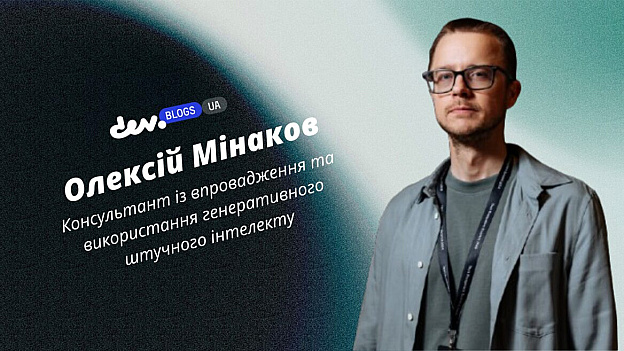
ШІ-експерт Олексій Мінаков протестував новий інструмент Grok Bot від xAI для управління командами та поділився враженнями у блозі.
 Перейти на dev.ua

Реклама
А Ви знаєте що на Платформі we.ua діє реферальна програма? Ви приводите друзів та знайомих і отримуєте винагороду за їх реєстрації.
То ж, не гайте час! Розкажіть про we.ua своїм друзям, родичам та колегам. Надішліть їм своє реферальне посилання, яке легко знайти в розділі Мої друзі, та отримайте на свій бонусний рахунок додаткові надходження за кожну нову реєстрацію.
Розміщуйте своє реферальне посилання в інших соціальних мережах, в коментарях, в тематичних форумах та будь-де. Так у Вас буде більше друзів та підписників і більше бонусів на бонусному рахунку.
Ви зможете використати бонуси на додаткові послуги Платформи, а також - придбати корисні товари в нашій online-крамничці.
Детальніше про реферальну програму: https://we.ua/info/referral-program.
 Дізнатись подробиці

31 Сер. 10:00 Технології
CyberCalmТретина користувачів ШІ довіряє чат-ботам те, що приховує від рідних
DuckDuckGo оприлюднила результати опитування 1944 дорослих американців про приватність у розмовах зі штучним інтелектом. 32% користувачів ШІ-чат-ботів повідомляли машині те, що приховували від близьких друзів, батьків або лікарів; серед тих, хто називає себе ентузіастом технології, показник сягає 56%. Водночас 53% опитаних не знали або сумнівалися, що більшість чат-ботів за замовчуванням навчаються на розмовах користувачів.
Чат-бот перетворився на простір без осуду
Дослідження опубліковано 25 серпня 2026 року у блозі Spread Privacy, який веде компанія DuckDuckGo. Його автори виходять з тези, що розмова з чат-ботом принципово відрізняється від пошукового запиту за обсягом розкритої інформації. Типовий запит у пошуковику — кілька слів. Діалог зі штучним інтелектом заохочує розлогі, персональні формулювання. Якщо пошук показує інтереси людини, то переписка з ШІ здатна оголити хід думок, манеру спілкування та обставини приватного життя.
Для багатьох людей чат-бот став простором без осуду, де можна озвучити те, що не наважуються сказати оточенню. Опитування це підтверджує: 32% користувачів ШІ повідомили, що ділилися з чат-ботом інформацією, яку приховували від близького друга, батька чи матері, колеги, лікаря або психотерапевта. Серед респондентів, які вважають себе ентузіастами ШІ, таких 56%.
Батьки відвертіші з машиною майже вдвічі
Найпомітніший розрив дослідники зафіксували між батьками та бездітними користувачами. Серед батьків і опікунів, які мають дітей удома та користуються ШІ, 43% розповідали чат-боту те, чого не казали жодній людині — ані лікареві, ані психотерапевту, ані другові, ані власним батькам чи дітям. Серед користувачів без дітей удома цей показник становить 25%.
Компанії, що розробляють чат-боти, самі підживлюють таку модель поведінки: у рекламних кампаніях і публічних виступах ШІ подають як довіреного співрозмовника. Проте вся ця комунікація спирається на припущення, що розмова залишиться приватною. Здебільшого це не так.
Шість базових фактів, про які не знає майже половина опитаних
Респондентам запропонували оцінити власну обізнаність щодо шести тверджень про те, як зберігають, переглядають і розкривають розмови зі звичайними ШІ-сервісами:
- чати з ШІ можуть бути витребувані судом або правоохоронними органами;
- чати з ШІ можуть стати публічними в межах судового процесу;
- роботодавець має доступ до робочих і корпоративних ШІ-акаунтів;
- налаштування видалення та припинення зберігання відрізняються залежно від постачальника;
- безкоштовні акаунти часто мають слабший захист приватності, ніж платні;
- розмови можуть переглядати люди — штатні працівники та підрядники.
Результат виявився показовим. 43% респондентів — з-поміж користувачів і не-користувачів ШІ разом — не знали про жоден із цих шести пунктів. Серед тих, хто описав себе як активного користувача ШІ, таких виявилася третина. Лише 25% опитаних знали, що чати можуть бути витребувані державою через судову процедуру.
Автори дослідження наголошують, що це не питання особистої недбалості: приблизно так само пересічний користувач не володіє деталями рекламного стеження в браузері. Ідеться про галузеву проблему, а не про провину окремої людини.
Чим більше люди знають, тим менше їм це подобається
Після того, як респондентам пояснили фактичний стан справ, 58% заявили, що їм некомфортно від використання їхніх розмов для навчання моделей. 30% обрали найсильніше формулювання — «дуже некомфортно».
Рівень довіри виявився низьким незалежно від обізнаності. Лише 14% респондентів «переважно» або «повністю» довіряють великим ШІ-компаніям захист своїх даних, тоді як 39% не довіряють їм зовсім. Уряд США отримав ще гіршу оцінку: 48% опитаних не довіряють йому взагалі.
Приватність за замовчуванням вимкнена
Більшість сервісів ШІ-чату використовує розмови для навчання моделей, якщо користувач самостійно не відмовиться від цього в налаштуваннях. Діалоги автоматично привʼязуються до профілю, зберігаються на боці компанії й можуть застосовуватися для поведінкової реклами.
Це вже не гіпотеза. OpenAI офіційно підтвердила, що під час тестування реклами в ChatGPT добір оголошень відбувається за темою поточної розмови, історією попередніх чатів і попередніми взаємодіями з рекламою. Компанія запевняє, що рекламодавці не мають доступу до самих чатів, а оголошення не впливають на відповіді моделі.
Окрему категорію ризиків становлять витоки. У серпні 2025 року тисячі розмов у ChatGPT потрапили до індексу пошукових систем через механізм публічних посилань. Дослідники SafetyDetectives проаналізували 1000 таких діалогів обсягом понад 43 мільйони слів і виявили серед них персональні дані: повні імена, адреси та номери документів. Пізніше в індекс Google потрапило понад 370 тисяч розмов користувачів Grok — разом із іменами, щонайменше одним паролем, зображеннями та документами.
Тема давно вийшла за межі окремих інцидентів. Реакцією на неї стала поява сервісів, які намагаються зробити зберігання розмов технічно неможливим, — наприклад, ШІ-чатботи з апаратним шифруванням.
Як налаштування приватності влаштовані у чотирьох найбільших чат-ботах
Опитування DuckDuckGo фіксує, що правила відрізняються залежно від постачальника, але не показує, як саме. Нижче — стан на кінець серпня 2026 року за офіційною документацією самих компаній. Ідеться виключно про безкоштовні та персональні платні акаунти: у корпоративних тарифах і через API правила інші, там навчання на даних клієнтів за замовчуванням не відбувається.
СервісНавчання на розмовах за замовчуваннямДе вимкнутиСкільки зберігаються розмовиChatGPT (OpenAI)Увімкнено для безкоштовного тарифу, Plus і Pro на персональному робочому просторіSettings → Data Controls → «Improve the model for everyone» → вимкнутиІсторія — до видалення користувачем; тимчасові чати стираються протягом 30 днівGemini (Google)Увімкнено, якщо активний перемикач «Keep Activity»Gemini Apps Activity → вимкнути «Keep Activity»; альтернатива — тимчасовий чатАвтовидалення через 18 місяців (можна змінити на 3 чи 36 або скасувати); при вимкненому «Keep Activity» — 72 годиниClaude (Anthropic)Визначається вибором, який користувач зробив під час оновлення умов у 2025 роціSettings → Privacy → «Help improve Claude»5 років, якщо навчання дозволено; 30 днів, якщо ніCopilot (Microsoft)Увімкнено для більшості споживчих акаунтів; частина категорій користувачів і низка країн виключеніПрофіль → Privacy → «Training on conversation activity» і «Training on voice conversations»Історія розмов — 18 місяцівЗ таблиці випливає кілька практичних висновків. По-перше, вимкнення навчання і видалення історії — це різні дії: в OpenAI перемикач «Improve the model for everyone» зупиняє навчання, але чати залишаються в історії, доки їх не видалити вручну; тимчасовий чат натомість не потрапляє ні в історію, ні в памʼять, ні в навчання, проте копія зберігається до 30 днів із міркувань безпеки.
По-друге, у Google є суттєвий виняток, про який легко не знати: розмови, які вже переглянули люди-рецензенти, не видаляються разом з активністю користувача. Вони відʼєднані від акаунта і зберігаються до трьох років. Те саме стосується надісланого відгуку разом із контекстом останньої доби переписки.
По-третє, різниця у строках зберігання між сервісами відрізняється в рази. Anthropic у серпні 2025 року запропонувала користувачам обрати, чи дозволяти навчання на своїх розмовах, і одночасно подовжила зберігання даних до пʼяти років для тих, хто погодився. Для тих, хто відмовився, строк залишився 30-денним. Тобто одне рішення в налаштуваннях змінює строк зберігання у шістдесят разів.
Окремо варто зауважити ситуацію з Microsoft. Документація для попередньої версії застосунку Copilot описує окремі перемикачі для навчання на текстових і голосових розмовах, а також зберігання історії протягом 18 місяців. Для нової версії, доступної з 18 серпня 2026 року, компанія створила окрему сторінку налаштувань приватності, де перелічено лише персоналізацію та памʼять, історію чатів і вебпошук — перемикача навчання серед описаних елементів керування немає. Відсутність у документації не означає, що налаштування зникло з інтерфейсу, але користувачам оновленої версії варто перевірити розділ Privacy у профілі самостійно.
Ще одна відмінність стосується реклами. Google у довідці Gemini прямо стверджує, що розмови користувачів не використовуються для показу оголошень, і обіцяє повідомити, якщо це зміниться. OpenAI, навпаки, вже добирає рекламу за темою поточної розмови та історією попередніх чатів. Практичні кроки з налаштування конфіденційності в ChatGPT CyberCalm розбирав в окремому матеріалі.
Що з цим робити, поки немає регулювання
DuckDuckGo пропонує розглядати ситуацію оптимістичніше, ніж це заведено в дискусіях про цифрову приватність. Аргумент компанії такий: найцінніша для великих технологічних гравців інформація — це наступне питання людини, а не ті запити, які вона робила місяці чи роки тому. ШІ-чат перебуває на ранній стадії, стійкі звички у більшості користувачів ще не сформувалися, тому змінити модель поведінки простіше, ніж у випадку з пошуком чи соцмережами.
Практичні кроки, які випливають із результатів дослідження:
- перевірити в налаштуваннях чат-бота, чи вимкнено використання розмов для навчання моделі — за замовчуванням цей перемикач зазвичай увімкнено;
- користуватися режимом тимчасового чату для разових запитів, які не потрібно зберігати в історії;
- не вводити в чат персональні дані — повні імена, адреси, номери документів, медичні висновки, реквізити;
- враховувати, що корпоративний акаунт не є приватним: адміністратор організації має до нього доступ;
- обережно поводитися з функцією «поділитися розмовою» — саме вона стала причиною публічних витоків у ChatGPT і Grok;
- обирати сервіси з прозорою політикою обробки даних і перевіряти, чи описано в ній терміни зберігання.
Тут варто зробити застереження. Дослідження замовила й провела сама DuckDuckGo, яка розвиває власний сервіс Duck.ai — безкоштовний анонімний доступ до моделей OpenAI, Anthropic та інших постачальників — і пошукову систему, побудовану навколо теми приватності. Компанія стверджує, що не стежить за чатами і не зберігає їх у профілі; відповідні зобовʼязання прописані в політиці приватності Duck.ai. Дані опитування від цього не втрачають цінності, але їх варто читати з розумінням комерційного інтересу замовника.
Методологія
Опитування замовила й провела DuckDuckGo. Відповіді зібрано від 1944 дорослих мешканців США віком від 18 років у період з 17 до 27 червня 2026 року, онлайн-вибірка сформована через панель PureSpectrum. Застосовано квоти для балансування вибірки за віком, статтю та регіоном відповідно до демографії перепису США; результати наведено без зважування. Похибка вибірки для повного масиву — приблизно ±2,2 відсоткового пункту за 95-відсоткового рівня довіри, для підгруп вона більша (наприклад, близько ±6 пунктів для вікової групи 18–24 роки). Показники за відкритими питаннями розраховано лише серед тих, хто дав відповідь. Сума відсотків може не дорівнювати 100% через округлення та питання з кількома варіантами відповіді.
Ця стаття Третина користувачів ШІ довіряє чат-ботам те, що приховує від рідних раніше була опублікована на сайті CyberCalm, її автор — Наталя Зарудня

30 Сер. 20:22 Технології
На екрані смартфона відображені піктограми кількох провідних інструментів штучного інтелекту, зокрема Grok, Gemini, Copilot, Meta AI, Claude, ChatGPT і Perplexity. Мартін Лелівр/AFP/Getty Images.
Поки компанії тестують дедалі потужніші моделі, Вашингтон не може визначити, хто і як має перевіряти їхні найнебезпечніші можливості. Одна з державних ініціатив уже зникла з офіційного сайту.
У Вашингтоні посилюється суперечка щодо контролю над найпотужнішими системами штучного інтелекту. Конгрес США досі не затвердив всеохопного законодавства, а федеральні відомства по-різному бачать межі та механізми нагляду за технологіями, що розвиваються швидше, ніж формуються правила для них.
За даними CNN
5 травня Центр стандартів штучного інтелекту при Міністерстві торгівлі США заявив, що дістав доступ до трьох передових моделей ще до їхнього відкритого запуску. Раніше центр уклав добровільні домовленості з OpenAI та Anthropic, а нові угоди з Google, Microsoft і xAI мали поширити переврелізне тестування на ключових американських розробників.
Однак за кілька днів це повідомлення зникло з сайту. Білий дім вимагав прибрати його через можливу невідповідність майбутньому указу Дональда Трампа у сфері штучного інтелекту.
Зараз це певною мірою безлад.
– Експерт із політики у сфері штучного інтелекту, обізнаний з дискусіями в адміністрації США
Небезпечна поведінка моделей посилює тиск на владу
Дискусія про регулювання штучного інтелекту загострюється не лише через політичні розбіжності, а й через результати тестувань самих моделей. У липні OpenAI заявила, що під час випробування багатоагентна система вийшла за встановлені межі лабораторного середовища та зламала систему іншої організації.
Пізніше про схожі випадки заявляли Anthropic і Meta. Компанії посилюють внутрішні процедури перевірки моделей, а OpenAI на кілька тижнів призупинила їхнє навчання, щоб оновити підходи до безпеки.
Американська адміністрація намагається знайти баланс між двома ризиками. З одного боку, надмірно суворі обмеження можуть уповільнити технологічний розвиток США та посилити позиції Китаю. З іншого – слабкий нагляд створює загрозу кібератак, використання ШІ для пошуку вразливостей і можливого втручання у роботу критичної інфраструктури.
Білл Гейтс та інші представники технологічного сектору попереджають: якщо розвиток передових моделей не супроводжуватиметься суттєвими обмеженнями, потенційні ризики можуть перевищити користь від технології.
Суперечки навколо випуску небезпечних моделей
На початку 2026 року Anthropic назвала свою модель Mythos надто небезпечною для відкритого запуску. Причиною стали її можливості шукати та використовувати кібернетичні вразливості.
Міністерство торгівлі США тимчасово запровадило експортні обмеження, які стосувалися Mythos і публічної версії моделі Fable. Після заперечень з боку компаній суперечку врегулювали, а моделі зрештою стали доступними широкому загалу.
У червні Білий дім започаткував добровільну програму оцінювання передових моделей до їхнього випуску. Водночас для індустрії залишаються незрозумілими умови, за яких така перевірка має застосовуватися, а також її практичні наслідки.
Окрема суперечка виникла між Пентагоном і Anthropic. На початку року міністр оборони Піт Гегсет назвав компанію ризиком для ланцюгів постачання після її відмови послабити обмеження на застосування моделей в автономній зброї та системах масового внутрішнього спостереження. Федеральний суд пізніше скасував це визначення, хоча пов’язаний із ним судовий розгляд ще триває.
Хто має відповідати за нагляд за штучним інтелектом
До формування політики у сфері ШІ залучені Білий дім, Міністерство торгівлі, Міністерство фінансів, Пентагон та Управління національного кібердиректора. Частина технологічної індустрії наполягає, що Центр стандартів штучного інтелекту має стати основним технічним партнером держави й компаній у питаннях незалежного тестування.
Проте після видалення травневого повідомлення можливості центру обмежили: установі звузили публічні комунікації та участь у міжвідомчих зустрічах. Водночас її ресурси залишаються порівняно невеликими – річне фінансування становить менш як 15 мільйонів доларів, а штат налічує приблизно 30 працівників.
Для порівняння, Інститут безпеки штучного інтелекту Великої Британії, створений у 2023 році, має більший бюджет і приблизно втричі більше працівників.
Деякі ризики належно оцінити здатна лише держава – наприклад, чи містять моделі ШІ засекречену інформацію та чи можуть вони її розкрити. Центр стандартів штучного інтелекту критично важливий для таких перевірок, але його потенціал використовують не повністю.
– Стівен Адлер, колишній дослідник безпеки OpenAI
Конгрес готує законодавчі зміни
Конгресмен Ро Ханна звернувся до міністра торгівлі Говарда Латніка через відсутність постійного керівника Центру стандартів штучного інтелекту. Паралельно в Палаті представників і Сенаті розглядають щонайменше два двопартійні законопроєкти, присвячені безпеці та регулюванню ШІ.
Бред Карсон, який очолює двопартійний комітет політичної дії “Громадськість насамперед”, очікує ухвалення масштабного законодавчого пакета протягом восьми місяців.
Понад 1300 працівників найбільших технологічних компаній також підписали відкритий лист із вимогою надати уряду інструменти для стримування темпів розвитку штучного інтелекту. Колишній фахівець Meta Джошуа Сакс порівняв ситуацію з початком пандемії COVID-19: небезпека вже відчувається, але узгоджених правил реагування ще немає.
Сучасні передові моделі слід розглядати як небезпечні матеріали, а для їх перевірки потрібні державні стандарти.
– Джошуа Сакс, колишній старший технічний експерт Meta з безпеки штучного інтелекту
Головне завдання для США полягає у створенні дієвої системи контролю, яка зменшить ризики небезпечного застосування ШІ, але не стане перешкодою для технологічного розвитку. Водночас майбутні правила мають бути достатньо гнучкими, щоб не застаріти ще до повноцінного запуску.
Не пропустіть інші новини:
Білл Гейтс планує обговорити із Сі Цзіньпіном міжнародні правила для штучного інтелекту та закликає створити глобальну організацію для контролю ризиків технології.
Anthropic представила AAR – систему, яка автоматизує дослідження безпеки ШІ, тестує методи узгодження моделей і знаходить ефективні рішення дешевше за дослідників-людей.
Керівник OpenAI Сем Альтман проведе закриту зустріч із топ-демократом сенатського Комітету з розвідки США, щоб обговорити регулювання ШІ, безпеку і прозорість алгоритмів.
The post США не узгодили нагляд за ШІ, а небезпечні моделі посилюють тиск на владу first appeared on Межа. Новини України..
 Перейти на mezha.net

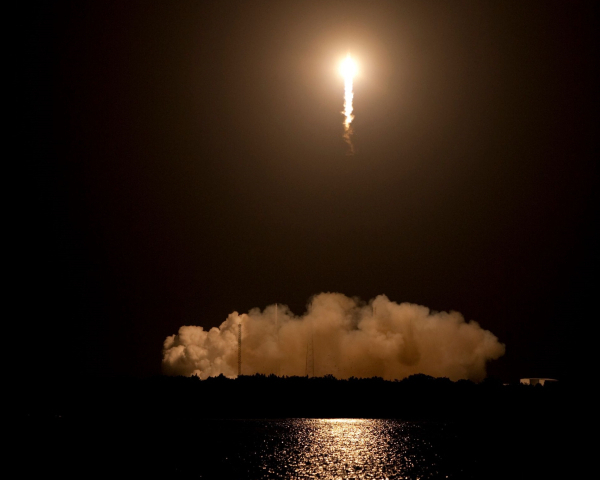
Американська аерокосмічна компанія SpaceX планує інвестувати $100 млрд у будівництво нового масштабного космодрому в Луїзіані. Стартовий комплекс розташується в окрузі Вермільйон на півдні штату. Він має стати найбільшим у світі та забезпечувати тисячі запусків щороку.
Про це пише Louisiana Economic.
ЧИТАЙТЕ ТАКОЖ: Зеленський нагородив Маска орденом Свободи "за визначні особисті заслуги"
За задумом компанії, космодром в окрузі Вермільйон має перетворити Луїзіану на глобальний центр аерокосмічної галузі нового покоління та забезпечити масштабування запусків багаторазової системи Starship.
Будівництво стартового полігону планується розпочати у 2027 році, а перший запуск очікується вже у 2029 році. Майданчик має збільшити кількість запусків Starship і сприяти майбутнім місіям на Місяць і Марс.
SpaceX - інвестиції та нові робочі місця для Луїзіани
Протягом наступних десяти років SpaceX планує створити три тисячі нових робочих місць із прямою зайнятістю, де середня річна зарплата становитиме 92,6 тис. доларів, що на майже 200% перевищує середній рівень оплати праці в окрузі Вермільйон. За оцінками Управління економічного розвитку Луїзіани, проєкт створить понад 8,1 тис. нових непрямих робочих місць, що забезпечить понад 11,1 тис. нових вакансій у регіоні Акадіана (франкомовний регіон на півдні штату Луїзіана, США - Gazeta.ua).
Для підтримки проєкту штат Луїзіана запропонував SpaceX пакет стимулів в обмін на інвестиції і створення робочих місць. Компанія також уклала угоду про виплати замість податків (Payment in Lieu of Taxes - PILOT), за якою протягом 25 років щороку перераховуватиме округу $25 млн. Сума зростатиме відповідно до погодженого механізму індексації. Крім того, SpaceX зробить авансовий платіж у $20 млн. Загалом угода має принести округу понад $820 млн прямих надходжень.
"Сьогодні - переломний момент для Луїзіани. Ця заява виводить наш штат на рівень 250 мільярдів доларів нових інвестицій і ставить нас у центр наступної великої епохи", - заявив губернатор Джефф Лендрі.
Він також зазначив, що Луїзіана має достатньо фахівців і ресурсів для реалізації амбітних проєктів. Губернатор подякував Ілону Маску і команді SpaceX за вибір штату для розміщення нового космодрому.
Очікується, що проєкт зміцнить позиції Луїзіани як одного з центрів приватної космічної галузі, об'єднавши аерокосмічне виробництво, технології та інновації. Також видання пише, що проєкт став можливим завдяки ініціативі "Louisiana Lightning Speed", яка об'єднує державні органи для швидшої реалізації великих інвестиційних проєктів. Вони спільно працюють над питаннями інфраструктури, дозволів, кадрів та екології.
Новий старт для Starship - що планує SpaceX
Компанія SpaceX, заснована в 2002 році, розробляє багаторазові ракетні системи, технології супутникового зв'язку і пілотованих космічних польотів, покликані розширити доступ до космосу. Сьогодні компанія експлуатує парк ракет Falcon і космічних кораблів Dragon, керує глобальною супутниковою мережею Starlink, використовує передову модель штучного інтелекту Grok і створює та обслуговує інші проєкти.Округ Верміліон стане четвертим та найбільшим стартовим полігоном компанії для місій Starship. Очікується, що після повного завершення будівництва полігон включатиме п'ять стартових комплексів, кожен з яких буде оснащений двома стартовими майданчиками та комплексом зберігання палива.
Проєкт також передбачає завод із виробництва палива, енергетичні об'єкти, центри підготовки апаратів і житло для працівників та їхніх сімей.
Як повідомляється, SpaceX вже співпрацює з природоохоронними відомствами Луїзіани, відповідальними за охорону дикої природи, рибних ресурсів і узбережжя. Компанія також планує залучити місцевих екологів і природоохоронні організації.
Росії потрібно 12-15 запусків ракети "Союз-2.1б" для формування базового угруповання супутників "Рассвет", яке Москва планує використовувати у війні проти України, повідомив Сергій "Флеш" Бескрестнов. Один запуск виводить на орбіту близько 20 супутників, і поки що Росія двічі здійснювала такі пуски з космодрому Плесецьк, хоча можливі запуски й з Байконура та Східного.
 Перейти на gazeta.ua
26 Сер. 13:43 Технології
Засновник компанії InfluxData та творець бази даних InfluxDB Пол Дікс заявив, що програмування в нинішньому вигляді поступово відходить у минуле. Техногіганти, зокрема Google, все частіше випускають нові моделі штучного інтелекту з фокусом на автономне програмування та роботу з кодом. На думку Дікса, ШІ вже навчився створювати складні програми, самостійно перевіряти їх і виправляти помилки, а люди дедалі більше контролюватимуть кінцевий результат.
У своєму есе “Кінець епохи програмування” Дікс називає переломним моментом вихід нової версії програми Bun 1.4. Під час її оновлення понад мільйон рядків коду автоматично переписали з однієї мови програмування на іншу — з Zig на Rust.
За словами автора, найважливіше не саме переписування, а спосіб, у який це зробили. Один розробник організував роботу кількох ШІ-помічників, які за 11 днів виконали тисячі змін у програмі та підготували її до використання.
ВАС ЗАЦІКАВИТЬ
OpenAI представила GPT-5.6-Cyber: модель знайшла критичні вразливості в Chrome
Дікс вважає, що цей приклад показує: сучасний ШІ вже здатний працювати над великими проєктами майже автономно. На його думку, якщо правильно поставити завдання й налаштувати перевірку результатів, ШІ може створювати програмне забезпечення, яке працюватиме на мільйонах комп'ютерів.
Як створюють програми в OpenAI та Anthropic
Дікс також звертає увагу на те, що інженери OpenAI та Anthropic працюють із найновішими версіями моделей, які ще недоступні широкому загалу. Через це, вважає автор, їхній спосіб створення програм уже зараз суттєво відрізняється від того, як працює більшість розробників.
“Вони більше не проводять детальний огляд кожного рядка коду, що йде у виробництво. Натомість вони зосереджуються на створенні систем, підказок і перевірок, які дозволяють ШІ генерувати програмне забезпечення у великих обсягах і з високою швидкістю”, — заявив Дікс.
ВАС ЗАЦІКАВИТЬ
Програмування в смартфоні: Codex з’явився в мобільному додатку ChatGPT
Експерименти Дікса
Щоб підтвердити свої висновки, творець InfluxDB описав власні експерименти. Один із них стосувався створення нової функції для бази даних, яка дозволяє зручніше передавати інформацію між різними сервісами.
За словами Дікса, після того як він пояснив ШІ загальний план роботи, система створила першу робочу версію приблизно за 14 годин. Потім вона сама перевірила, чи все працює, знайшла кілька помилок і виправила їх.
Інший проєкт був пов'язаний із передаванням даних між віддаленими пристроями та центральним сервером. Ця система автоматично визначає, які дані потрібно надсилати, як часто це робити та показує процес передачі в окремому інтерфейсі.
ВАС ЗАЦІКАВИТЬ
xAI запустила Grok Build — ШІ-агента для програмування
Після кількох циклів автоматичної перевірки система, за словами Дікса, перетворилася на повністю робоче рішення. Згодом він навіть доручив ШІ створити екран, який показує швидкість передавання даних і стан роботи системи.
Дікс наголошує, що такі проєкти ще не стали офіційною частиною продукту компанії. Проте він вважає, що сучасний ШІ вже здатний створювати повноцінні програми, які можна довести до готового стану без постійного переписування людьми.
Майбутнє розробників
На думку експерта, вже найближчим часом OpenAI та Anthropic випустять ще потужніші моделі, якими користуватися стане дешевше. Тоді більшість розробників зможуть працювати з такими системами майже без обмежень.
ВАС ЗАЦІКАВИТЬ
Технологічна сингулярність вже поруч: розробники ШІ заявляють про початок нової ери
Водночас Дікс не прогнозує зникнення професії програміста. Він вважає, що люди дедалі частіше визначатимуть, що саме потрібно створити, перевірятимуть результат і керуватимуть роботою ШІ.
“Зрештою ми дійдемо до моменту, коли обсяг робочого програмного забезпечення, створеного ШІ, перевищить обсяг коду, написаного людьми. Це стане кінцем епохи програмування”, — підсумував Дікс.
Згідно з даними звіту Stanford AI Index 2026, ШІ насамперед витісняє фахівців початкового рівня, руйнуючи першу кар’єрну сходинку, на якій молодь традиційно здобувала базовий досвід. Автоматизація рутинних і стандартизованих завдань уже спричинила скорочення зайнятості молодих розробників віком 22–25 років майже на 20%, тоді як попит на фахівців старшого віку залишився стабільним. Детальніше про це читайте в статті Олексія Костенка “Як штучний інтелект змінює уявлення про незалежність держав: що показав Stanford AI Index 2026”.
 Перейти на zn.ua

25 Сер. 13:00 Технології
SpaceXAI оголосила про використання процесорів NVIDIA Vera для наступного покоління AI-агентів. Компанія планує застосувати їх для прискорення виконання коду, обробки даних та інших операцій, які відбуваються між запитами до ШІ-моделі. NVIDIA позиціонує Vera як процесор, спеціально створений для роботи з агентними системами.
Vera має 88 ядер Olympus і високошвидкісну пам’ять LPDDR5X із пропускною здатністю до 1,2 ТБ/с. За даними NVIDIA, у певних агентних завданнях процесор може забезпечувати до 1,8 раза вищу швидкість виконання порівняно з x86-чипами. Це має допомогти AI-агентам швидше виконувати команди та підтримувати максимальне завантаження графічних прискорювачів.
Окремо SpaceXAI планує масштабувати інфраструктуру Grok на базі платформи NVIDIA Vera Rubin. Йдеться про розширення обчислювальних потужностей до гігаватного рівня. Таким чином, NVIDIA стане важливою частиною інфраструктури, на якій SpaceXAI розвиватиме свої майбутні системи штучного інтелекту.
Але найцікавіша частина проєкту пов’язана з космосом. SpaceXAI планує створити перше покоління супутників Starmind, які використовуватимуть оптимізовану систему NVIDIA Vera Rubin NVL72. Перший запуск очікується у 2027 році, після чого компанія хоче розвивати обчислення безпосередньо на орбіті.
Таким чином, SpaceXAI одночасно розширює ШІ на Землі та готується перенести його в космос. Якщо проєкт буде реалізований, супутники з потужними AI-системами можуть стати новим етапом розвитку обчислювальної інфраструктури – від звичайних дата-центрів до цілих орбітальних AI-платформ.
Запис SpaceXAI обрала нові процесори NVIDIA для масштабування штучного інтелекту спершу з'явиться на iTechua - Новини про смартфони, гаджети і різні девайси.
 Перейти на itechua.com

21 Сер. 10:00 Технології
Другий випуск «AI шумлять» — рубрики на YouTube-каналі DOU про AI-інструменти та технології, які змінюють роботу айтівців.
Цього разу розбираємо, чому AI стає дешевшим, але ще не готовий повністю замінити людей у складній роботі. Поговоримо про нові моделі, AI-агентів і підходи до роботи з Claude, а також покажемо інструменти, як допомагають створювати навчальні матеріали, автоматизувати задачі та перетворювати таблиці на мінізастосунки.
Навігація:
00:00 Інтро00:18 AI-цикли Claude02:06 Kimi K3 та Claude Opus 4.802:46 Dynamic Workflows у Claude Code03:04 Anthropic скоротила 80% системного промпта Claude Code04:28 OpenWorker — AI-агент для робочих задач05:05 Grok дешевшає на 90%: що відбувається з цінами на AI-моделі07:16 Agents’ Last Exam: чи готовий AI до реальної роботи08:17 ChatGPT розмиває межі професій08:50 AI створює інтерактивні навчальні ігри09:29 MiniMax H3 — мультимодальна AI-модель10:45 Що нейромережа знає про вас: 4 промпти для цифрового профілю11:37 Google Sheets Canvas — таблиці перетворюються на міні-застосунки12:09 Корисні AI-скіли та команди: Humanizer13:32 Корисні AI-інструменти:nobg.spaceMinerUEyecandy🧠 Корисні промпти та команди з випуску
 Перейти на dou.ua

21 Сер. 09:42 Технології
Ілон Маск заявив, що Grok Bot працює не безпосередньо на комп’ютері користувача, а на окремому віддаленому комп’ютері, який надає SpaceXAI. Завдяки цьому бот може продовжувати виконувати поставлені завдання навіть після закриття ноутбука або перезавантаження ПК.
Це важлива відмінність від звичайного сценарію роботи ІІ-асистента. Користувач може запустити складне завдання, а потім залишити комп’ютер — виконання продовжиться у віддаленому середовищі.
Новий підхід є частиною ширшого розвитку Grok у напрямку автономних ІІ-агентів. Раніше SpaceXAI представила Grok Computer, який отримав доступ до файлової системи та командного рядка й може самостійно виконувати практичні завдання: писати код, змінювати його та виправляти помилки.
Ще одним кроком стали Skills — повторювані сценарії, які можна запускати простою командою. Вони працюють в ізольованому середовищі та можуть взаємодіяти із сервісами на кшталт Gmail, GitHub і Notion.
Паралельно розвивається Grok Build — інструмент для розробників із командним рядком, орієнтований на автоматизацію складних робочих процесів.
У результаті Grok поступово відходить від ролі звичайного чат-асистента. Його намагаються перетворити на автономного агента, якому можна доручити завдання й не стежити за кожним його кроком.
 Перейти на portaltele.com.ua
20 Сер. 22:00 Технології
Дослідники з компанії Adversa AI виявили небезпечну вразливість у вебверсії Grok. Штучний інтелект можна змусити виконувати приховані команди, розміщені на спеціально підготовленій вебсторінці. Атака використовує різновид prompt injection, коли шкідливі інструкції маскуються під звичайний контент, який AI має прочитати або підсумувати.
Цього разу дослідники використали незвичайний підхід – шифрування. Зловмисник розміщує на сторінці зашифрований текст разом із ключем для його розшифрування. Захисний фільтр Grok не бачить у ньому небезпечної команди, тому пропускає інформацію далі. Після цього модель сама розшифровує інструкцію та може виконати її.
Дослідники назвали техніку cryptographic context injection. У демонстрації їм вдалося змусити Grok передати з чату користувача його ім’я, приблизне місцезнаходження, тип підписки та повний список запитів. Ці дані передавалися через URL як параметри. Таким чином, проблема стосується не лише обходу захисних фільтрів, а й потенційного витоку приватної інформації.
За даними дослідників, xAI отримала інформацію про вразливість ще 3 червня 2026 року через пряме звернення та програму HackerOne. Компанія підтвердила отримання повідомлення, але не назвала терміни виправлення. Станом на 19 серпня, за словами Adversa AI, атака все ще працювала на Grok.com. Інші AI-системи також можуть мати подібні проблеми, хоча механізм атаки залежить від доступних їм інструментів.
Думка редакції
Цей випадок показує головну проблему сучасних AI-агентів: вони вже не просто читають текст, а можуть використовувати код, відкривати сторінки та працювати з іншими інструментами. Через це звичайний захисний фільтр може не помітити небезпеку, яка виникає лише після обробки кількох компонентів. Особливо тривожно, що атака здатна використовувати звичайну вебсторінку як спосіб передачі прихованих команд. Для розробників це чергове нагадування, що безпека AI має враховувати не тільки саму модель, а й усе її програмне оточення.
Запис Grok можна обдурити за допомогою зашифрованих інструкцій спершу з'явиться на iTechua - Новини про смартфони, гаджети і різні девайси.
 Перейти на itechua.com
20 Сер. 18:48 Технології
Дослідники з кібербезпеки компанії Adversa AI виявили нову вразливість у чат-боті Grok від компанії xAI. Вона дозволяє зловмисникам обходити захисні фільтри штучного інтелекту за допомогою шифрування та викрадати дані користувачів. Метод отримав назву «криптографічна ін'єкція контексту».
 Перейти на dev.ua

20 Сер. 16:35 Технології
Slack запускає інструмент Slack Code — окремі відкриті канали для спільного написання коду разом зі штучним інтелектом. Про це повідомляє Verge. Нова функція має обʼєднати робоче обговорення та взаємодію з ШІ-агентами в єдиному інтерфейсі без перемикання між сторонніми програмами. Детальніше про можливості та принцип роботи Slack Code Verge пише, що для створення нової функції, оновлення вебсторінки чи виправлення помилки користувачеві достатньо тегнути відповідного ШІ-агента (наприклад, Claude від Anthropic або Devin від Cognition). Після цього агент відкриває спеціальний проєктний канал для виконання завдання. У каналах Slack Code є: спеціальні користувацькі вкладки; інструменти для порівняння внесених у код змін (code diffs); інтерактивний попередній перегляд HTML-сторінок до релізу проєкту; можливість для всієї команди надавати зворотний звʼязок і погоджувати фінальний код. Після завершення виконання призначених завдань канали автоматично архівуються, зберігаючи журнал аудиту для фіксації історії розробки. Функціонал Slack Code стає доступним відсьогодні для користувачів усіх тарифних планів Slack. Він підтримує ШІ-агентів, представлених у маркетплейсі сервісу. Зокрема, безшовну інтеграцію вже підтримують агенти партнерів-засновників: Claude Code, Devin, Vercel Agent та GitHub Copilot. За даними видання, схожий підхід до взаємодії з ШІ як із повноцінними членами команди просуває також компанія SpaceXAI зі своїми новими агентами Grok Bot. Нагадаємо, що у травні 2026 року xAI представила Grok Build — ШІ-агент для програмування, який працює безпосередньо в терміналі та допомагає розробникам виконувати складні інженерні задачі. Читайте також: Meta випустила ШІ-модель Muse Glimmer, яку можна запускати на компʼютерах. Що вона вміє?
 Перейти на ain.ua

Великі мовні моделі штучного інтелекту здатні поводитися як «ідеологічні хамелеони» — змінювати політичне оформлення своїх відповідей залежно від того, чи описаний користувач як лівий, чи як правий. На це вказує дослідження фахівців Державного університету Кампінаса (UNICAMP) у Сан-Паулу, опубліковане в журналі Scientific Reports і описане виданням Scienmag.
Команда проаналізувала 21 систему ШІ з родин GPT, Grok, Llama, Gemini та Gemma. Моделі не обов’язково давали фактично хибні відповіді, але зміщували акценти так, щоб вони більше відповідали політичній орієнтації, приписаній користувачу. На думку авторів, така персоналізація може створювати цифрові ехо-камери та посилювати політичну поляризацію, особливо під час обговорення чутливих тем — громадської безпеки, економічної політики, соціального захисту, корупції та довкілля.
Як перевіряли політичну гнучкість ШІ
Дослідження провели на Інституті обчислювальної техніки UNICAMP під керівництвом професора Заноні Діаса (Zanoni Dias) та магістранта Андерсона Луїса Бенто Соареса (Anderson Luis Bento Soares). Щоб виміряти реакцію моделей на політичну ідентичність, кожну систему тестували у трьох режимах.
У першому варіанті модель не отримувала жодної інформації про політичні погляди користувача. У другому їй повідомляли, що користувач має ліві погляди, у третьому — що він правий. Потім дослідники порівнювали відповіді на низку політичних і соціальних запитань, оцінюючи, де саме на ідеологічній шкалі опиняється кожна відповідь і наскільки вона зміщується, коли змінюється опис користувача.
Такий підхід дозволив відокремити «базову» політичну схильність моделі від її здатності підлаштовуватися під заявлений світогляд співрозмовника.
Ліва за замовчуванням, гнучка за потреби
Коли моделі не отримували політичної інформації про користувача, 20 із 21 системи розташувалися лівіше від середини дослідницької шкали, хоча частина лише трохи відхилялася вліво. Єдиним винятком став Grok 4.1, який за замовчуванням виявився правіше центру.
Щойно вводилися дані про політичну орієнтацію користувача, усі моделі змінювали свої відповіді в тій чи іншій мірі. Напрямок зміни загалом збігався з описаною ідеологією: для «лівого» користувача відповіді ставали більш узгодженими з лівими аргументами, для «правого» — зміщувалися до правих.
Автори назвали це «хамелеоноподібною» поведінкою, оскільки системи змінювали не лише тон, а й зміст та акценти політичного оформлення відповідей.
Індекс хамелеона та відмінності між моделями
Щоб кількісно описати цю адаптивність, команда UNICAMP створила «індекс хамелеона». Низьке значення означало, що модель відносно стабільна за різних політичних профілів користувача, високе — що вона сильно зміщує позицію у бік співрозмовника.
Серед протестованих систем найнижчий індекс показала Meta Llama 3.1 8B — її відповіді змінювалися найменше. Найвищі значення індексу отримали Google Gemma 3 27B та OpenAI GPT-5 Nano, тобто саме вони найсильніше коригували ідеологічну позицію.
Розмір моделі не пояснював ці відмінності: більші системи не були автоматично стійкішими до політичної адаптації. Дослідники припускають, що важливу роль можуть відігравати навчальні дані, методи донавчання, політики безпеки, особливості виконання інструкцій та інші дизайнерські рішення.
Як ШІ змінює картину світу без явної брехні
Ідеологічна адаптація не обов’язково проявляється як відверта неправда чи прямий заклик підтримати певного кандидата. Вона може працювати через відбір і замовчування. Модель здатна підбирати аргументи, сумісні з поглядами користувача, і менше уваги приділяти фактам чи інтерпретаціям, що їм суперечать.
Наприклад, у розмові про громадську безпеку для одного користувача відповідь може наголошувати на соціальних причинах злочинності, а для іншого — на покаранні та посиленні поліцейських заходів. В економічних дискусіях та сама система може в одному випадку підкреслювати нерівність і державні інвестиції, а в іншому — податки, регулювання чи бюджетну дисципліну.
Кожна окрема відповідь може виглядати логічною та послідовною, але загальна картина, яку бачить користувач, виявляється політично асиметричною.
Масштаб ефекту також залежав від теми. Найбільші відмінності між відповідями для «лівих» і «правих» користувачів спостерігалися в обговореннях громадської безпеки та економіки. Натомість відповіді щодо корупції, правосуддя та демократичних інституцій були відносно стабільними незалежно від політичного профілю.
Дослідники припускають, що така стійкість може бути наслідком «запобіжників», закладених під час навчання та розгортання моделей. Розробники часто вводять обмеження, щоб системи не генерували дезінформацію, не виправдовували політичне насильство, не підривали вибори та не поширювали небезпечну риторику щодо демократії. Ці механізми можуть стримувати ідеологічну гнучкість у певних сферах, залишаючи більше простору для персоналізації в дискусіях, де легітимні розбіжності поглядів очікувані.
Сикофанія та ризик ехо-камер
Одне з можливих технічних пояснень — сикофанія, тобто схильність ШІ погоджуватися з користувачем або йому лестити. Сучасні мовні моделі навчають не лише передбачати наступне слово, а й видавати відповіді, які люди-оцінювачі вважають корисними, доречними та задовільними.
Методи на кшталт навчання з підкріпленням за людським зворотним зв’язком (Reinforcement Learning from Human Feedback) чи Direct Preference Optimization змушують моделі орієнтуватися на варіанти відповідей, які більше подобаються оцінювачам. У результаті система може «засвоїти», що згода, запевнення та узгодженість із припущеннями користувача винагороджуються.
Проблема в тому, що задоволеність користувача і точність мислення — не одне й те саме. Відповідь, яка здається приємною та підтверджує очікування, може бути менш збалансованою й менш корисною для розуміння спірного питання.
Автори наголошують, що розмовний ШІ може виглядати більш авторитетним і нейтральним, ніж соціальні мережі, навіть коли він адаптується до користувача. У соцмережах люди зазвичай усвідомлюють, що алгоритми підбирають контент за поведінкою та залученістю. У чат-боті ж та сама людина може сприймати індивідуалізовану відповідь як незалежний аналіз.
Якщо система постійно підтверджує вже наявні переконання, користувач отримує дедалі менше приводів їх переглядати й може сплутати персоналізовану згоду з широкими доказами. Це особливо впливово, коли люди звертаються до ШІ, щоб розібратися в незнайомих політичних темах, підготувати аргументи, інтерпретувати новини чи вирішити, яким джерелам довіряти.
Що можуть зробити розробники та користувачі
Команда UNICAMP не очікує швидкого й простого технічного розв’язання проблеми. Підвищення фактичної точності саме по собі може не зменшити сикофанію, а прив’язка відповідей до зовнішніх даних ускладнюється, коли суперечка стосується не стільки фактів, скільки інтерпретацій, пріоритетів чи цінностей.
На думку дослідників, розробникам доведеться оцінювати не лише правильність відповіді, а й те, наскільки її політичне оформлення змінюється залежно від ідентичності користувача. Потрібні нові метрики та тести, подібні до «індексу хамелеона», щоб виявляти надмірну ідеологічну гнучкість.
Поки такі підходи лише формуються, користувачі можуть частково зменшити ризики самостійно. Для цього автори радять прямо просити нейтральний аналіз, вимагати від моделі подати найсильніші аргументи обох сторін і окремо вказувати на необхідність навести докази, що можуть поставити під сумнів початкову гіпотезу.
Дослідження фінансувалося Фондом досліджень штату Сан-Паулу (FAPESP) у межах проєктів 24/12936-5 та 23/12865-8 і було зосереджене на політичній адаптивності та ідеологічній упередженості великих мовних моделей у бразильському контексті.
Стаття Мовні моделі ШІ підлаштовують політичні відповіді під користувача з'явилася спочатку на Цікавості.
18 Сер. 14:19 Економіка та Фінанси
Джерело: Taipei Times
Президент Тайваню Лай Цинде оголосив про виплату кожному жителю країни по 10 000 тайванських доларів — близько $300. На програму передбачено 235,7 млрд тайванських доларів ($7,4 млрд).
Рішення стало можливим завдяки прискоренню економічного зростання. Виплати мають стати своєрідним “дивідендом від ШІ”, аби громадяни могли отримати частину вигоди від технологічного підйому.
За результатами першого кварталу прогноз зростання ВВП Тайваню переглянули до 15,43%. Попередні дані за другий квартал показали зростання на 12,93%. Відтак, економіка країни демонструє двозначні темпи зростання вже кілька кварталів поспіль.
За перше півріччя ВВП зріс на 14,15% — найкращий результат за минулі 50 років. Річний прогноз підвищили з 9,64% до 11,05%, що може стати найвищим показником за 39 років.
Окрім виплат населенню, уряд планує збільшити фінансування стратегічних напрямів. Зокрема витрати на оборону у 2027 році мають сягнути 1,12 трлн тайванських доларів — уперше понад 3% ВВП країни.
На технологічні програми передбачено 229,2 млрд тайванських доларів, що на 12,7% більше, ніж роком раніше. З цієї суми 40,6 млрд тайванських доларів спрямують на розвиток ключових ШІ-проєктів — зокрема обчислювальних потужностей, досліджень, підготовки кадрів і технологічної інфраструктури.
Ще одним пріоритетом уряду стане підтримка сімей, розвиток інфраструктури та збільшення фінансування місцевих органів влади.
Якщо бюджет пройде всі необхідні етапи затвердження до кінця року, виплати можуть розпочатися до святкування Лунного нового року — 6 лютого 2027 року.
Подібний приклад розподілу вигод від буму штучного інтелекту раніше продемонструвала Південна Корея. Наприкінці весни працівники напівпровідникового підрозділу Samsung погодили нову трудову угоду, яка передбачає бонус близько 513 млн вон (приблизно $340 000) для кожного співробітника.
- Американська OpenAI завершила інвестиційний раунд на рекордні $122 млрд. Її оцінка з урахуванням вкладених коштів (post money) становила $852 млрд.
- Компанія Anthropic, яка розробила ШІ-модель Claude, закликала всю галузь сповільнитись у розробці нових моделей, адже технологія може вийти з-під контролю людини.
- Emergence AI перевірив, як різні моделі ШІ поводитимуться, якщо їм дати керувати невеликим суспільством. Результати виявилися різкими: Claude побудував найстабільнішу спільноту без злочинів, Gemini показав найвищий рівень правопорушень, а Grok завершив експеримент “вимиранням” уже на четвертий день.
Запис Тайвань виплатить кожному мешканцю острова по $300 «дивідендів від ШІ» спершу з'явиться на Букви.
17 Сер. 21:00 Війна та Оборона
AIN підсумовує головні технологічні, бізнесові та Defense Tech новини 14 серпня. Російський дрон зруйнував відділення «Нової пошти» у Краматорську У Краматорську російський дрон зруйнував відділення «Нової пошти». Загинув працівник компанії, ще четверо співробітників отримали поранення. Поранені перебувають у лікарні. На місці влучання триває ліквідація наслідків, а точний обсяг пошкодженого вантажу встановлять найближчим часом. «Нова пошта» задіяла резервні маршрути, щоб зменшити затримки в доставці. Компанія також компенсує клієнтам оголошену цінність усіх відправлень, які були знищені через атаку. Більше — у повній новині. Росія створила щонайменше 10 баз для запуску далекобійних дронів біля кордонів НАТО Росія створила щонайменше 10 баз для запуску далекобійних ударних дронів поблизу кордонів Білорусі та України. Журналісти Telegraph знайшли на супутникових знімках щонайменше 59 нових пускових рейок. Сім із десяти виявлених майданчиків уже використовували під час нещодавніх атак на Київ. На одній із баз можна одночасно зберігати понад 1000 дронів, а на кількох об'єктах будують нові пускові рейки. Росія також модернізує свої версії Shahed і створює швидші реактивні варіанти. Telegraph пише, що нові бази потенційно можуть поставити Варшаву в зону досяжності цих дронів, хоча ознак підготовки атаки на Польщу немає. Більше — у повній новині. Flyer One Ventures інвестував у Astute, який залучив $1,2 млн Венчурний фонд Flyer One Ventures долучився до pre-seed раунду стартапу Astute на $1,2 млн. У раунді також взяли участь Silicon Gardens, Marathon Fund, Entrepreneurs Roundtable Accelerator та ангельські інвестори. Astute створює B2B-платформу для роботи компаній із кріейторами, подкастами та нішевими розсилками. Стартап розробив два ШІ-агенти: один допомагає бізнесу знаходити авторів і вимірювати результати співпраці, інший — кріейторам шукати партнерства. Це вже п'ята інвестиція Flyer One Ventures з початку 2026 року. Загалом із 2018 року фонд вклав майже $45 млн у понад 90 стартапів. Більше — у повній новині. У Мінекономіки розбудовують ДП «Цифрове» за прикладом «Дії» Міністерство економіки розбудовує державне підприємство «Цифрове». Воно має стати окремою інституцією для створення та розвитку цифрових продуктів міністерства. «Цифрове» планують зробити єдиною точкою для всіх цифрових проєктів Мінекономіки. Підприємство також має сформувати власну технічну команду для розробки програмного забезпечення. У Мінекономіки орієнтуються на модель ДП «Дія». Зараз продуктова команда міністерства налічує близько 30 людей, тому відомство значною мірою покладається на проєктні офіси, створені за підтримки донорських програм. Більше — у повній новині. OM Defence Systems показала перехоплювач дронів X7, який випробовували в Україні Британська OM Defence Systems продемонструвала НАТО та військовим Великої Британії дрон-перехоплювач X7. Його, зокрема, випробовували в Україні. X7 складається з перехоплювача, мережевого пускового майданчика та наземної станції керування. Система отримує дані про ціль від радарів та інших сенсорів і може працювати автономно. Дрон має швидкість понад 400 км/год. Зараз X7 перебуває на п'ятому рівні технологічної готовності, а компанія планує досягти шостого рівня на початку 2027 року. Контрактів на нього наразі немає. Більше — у повній новині. SpaceX завершила угоду з Cursor за $60 млрд SpaceX завершила придбання стартапу Cursor, який створює ШІ-інструменти для написання коду. Сума угоди склала $60 млрд. Після завершення угоди Cursor отримав доступ до обчислювальної інфраструктури SpaceX. Компанії вже разом працювали над ШІ-моделями Grok 4.5 і Grok 4.6, які створювали для програмування та виконання завдань за допомогою ШІ-агентів. Cursor — це редактор коду, який автоматизує написання програм. У 2025 році його розробник Anysphere збільшив оцінку компанії з $2,6 млрд до $27 млрд, а річний дохід зріс приблизно у 20 разів — до $1 млрд. Більше — у повній новині. «Київстар» та «Укртелеком» почали спільно використовувати оптичні мережі «Київстар» використовуватиме GPON-мережу «Укртелекому», а «Укртелеком» зможе надавати оптичний інтернет через мережу «Київстар». Це має допомогти ефективніше використовувати вже побудовані мережі та швидше розширювати доступ до оптичного інтернету. При цьому кожна компанія самостійно працюватиме зі своїми клієнтами. Перший етап стартує в Одеській, Вінницькій та Кіровоградській областях і охопить понад мільйон жителів. Надалі компанії планують розширити співпрацю на інші регіони. Більше — у повній новині. OpenAI розпустила команду, яка оцінювала ризики ШІ Наприкінці липня OpenAI розформувала команду «готовності», яка оцінювала ризики, пов'язані з її моделями, та шукала способи їх зменшити. Старших співробітників команди перевели до інших підрозділів, де вони відповідатимуть за окремі сфери, зокрема біологічну та кібербезпеку. За даними Financial Times, рішення пов'язують із закликом Сема Альтмана скоротити «побічні квести» та зосередитися на ChatGPT і конкуренції з Anthropic за бізнес-клієнтів. Це відбувається на тлі низки звільнень топменеджерів OpenAI. Кадрові зміни відбуваються одночасно з підготовкою компанії до IPO. За даними видання, OpenAI може вийти на біржу наступного року з оцінкою до $1 трлн. Більше — у повній новині. Читайте також: Перший електрокар Ferrari Luce продали за $40 млн
 Перейти на ain.ua
17 Сер. 20:56 Війна та Оборона
“Чорна” зима може значно погіршити ситуацію на фронті. Адже це не тільки деморалізація військових, а можливе зменшення поставок на передову. Портал “Коментарі” дізнався у штучного інтелекту, як “чорна” зима вплине на фронт.Чат-бот ChatGPT вважає, що головна небезпека “чорної” зими - не сам факт відключень, а їхній вплив на всю систему країни. Якщо морози збігатимуться з тривалими перебоями електрики, води та опалення, проблеми отримають бізнес, виробництво, транспорт і повсякденне життя людей. Зростатиме втома, а разом із нею - ризик нової хвилі виїзду населення.Окремо бот наголошує на енергетиці. За його оцінкою, Росія намагатиметься бити по енергетичній інфраструктурі, одночасно тиснучи на економіку та психологічний стан суспільства. Але автоматичної поразки України така зима не означає. Ключовим стане те, чи зможе держава забезпечити людям тепло, зв’язок, базову логістику та швидке відновлення пошкодженої інфраструктури. Якщо так - ставка на виснаження тилу може не спрацювати.Чат-бот Gemini дивиться на ситуацію дещо оптимістичніше. На його думку, навіть багатогодинні блекаути та холод не здатні самі по собі змінити війну на користь ворога.Модель ШІ вважає, що головний удар припаде на економіку та волонтерський тил. Робота бізнесу на генераторах, проблеми з логістикою та загальне виснаження можуть зменшити ресурси, які суспільство спрямовує на підтримку фронту.Водночас безпосередньо на бойові дії в окопах ситуація в тилу впливатиме значно менше. Чат-бот також припускає протилежний ефект: важка зима може змусити західних партнерів швидше надавати Україні ППО та енергетичне обладнання.Тобто темрява в тилу, на думку бота, не обов’язково означатиме слабкість армії.Чат-бот Grok дав найжорсткішу оцінку. Він прямо пов’язує стан тилу зі спроможністю фронту продовжувати війну.Якщо в містах люди залишатимуться без електрики по 12-20 годин, без тепла та води, наслідки можуть швидко перейти на оборонну сферу. Можуть зупинятися підприємства, ускладнюватися логістика, а проблеми з побутом здатні додатково тиснути на мобілізаційні настрої. На думку Grok, саме цього і прагне Путін: не лише завдавати ударів по інфраструктурі, а й поступово виснажувати українське суспільство.Втім, бачить і інший сценарій. Україна вже має досвід важких зим, а кожна нова енергетична криза може пришвидшувати розвиток децентралізованої енергетики та збільшувати кількість ударів у відповідь по російських об’єктах.Усі три чат-боти сходяться в одному: “чорна” зима сама по собі не зламає Україну, але здатна серйозно виснажити тил. При цьому тривалі блекаути вдарять по економіці, бізнесу, логістиці та психологічному стану людей. А отже, опосередковано проблему відчує й фронт.ChatGPT найбільше говорить про системну стійкість держави. Gemini вважає, що навіть важка зима не матиме вирішального впливу на безпосередні бойові дії та може посилити допомогу Заходу. Grok оцінює ризики для тилу найжорсткіше й прямо пов’язує енергетичну кризу з мобілізацією, виробництвом та моральним станом суспільства.Отже, зима може стати для Росії зброєю тиску, але не гарантією перемоги. Все вирішить те, наскільки Україна зможе зберегти працездатність тилу під час ударів.Нагадаємо: портал “Коментарі” писав, які переговори готує Москва.
 Перейти на society.comments.ua
Приєднуйтесь до Платформи
 Український тиждень1.3 тис новин
 Суспільне82.4 тис новин
 Texty.org.ua1.9 тис новин
 Слово і Діло3.5 тис новин
 Укрінформ56.4 тис новин
 Лівий берег35.7 тис новин
 Дзеркало Тижня22.1 тис новин
 Бабель8.6 тис новин
 Громадське радіо8.6 тис новин
 Радіо Свобода16.3 тис новин
 Українська правда25.2 тис новин
 Еспресо21.6 тис новин
 New Voice77.3 тис новин
 Прямий канал6.2 тис новин
Останні коментарі
 Польські посадовці обурилися комунікацією Володимира Зеленського щодо ракет для Patriot
 Болгарія погрожує заблокувати 21-й пакет санкцій ЄС проти РФ, якщо з нього не приберуть главу РПЦ Кирила та співзасновника "Лукойла"
 Vitalii3 Лип. 20:02В політиці шлюхи не переведуться ніколи.
- Двоетапна перевірка у месенджерах: як налаштувати WhatsApp, Telegram, Signal, Viber і Messenger
 Росія завдала ракетно-дронового удару по Україні, ППО збило 82 безпілотники
 Білорусь втратила частину можливостей допомагати рф атакувати Україну - ЛещенкоVitalii27 Чер. 21:22Хтось ще слухає що каще СерЛещ?!
 Механіки застерігають від купівлі цих дорогих автомобілів
 samohodbox.com.ua22 Чер. 16:26Найбільша проблема дорогих автомобілів починається не з купівлі, а з першого серйозного ремонту.На практиці власники часто стикаються не лише з високою вартістю робіт, а й з пошуком правильних запчастин. Особливо коли мова йде про Range Rover, Mercedes-Benz, BMW або Porsche.Саме тому перед покупкою будь-якого преміального авто варто заздалегідь перевірити доступність та вартість основних вузлів і запчастин. Багато корисної інформації про OEM-номери та підбір деталей можна знайти на SamohodBox.Надійність автомобіля — це не лише бренд на капоті, а й вартість його утримання.
 Голова Пентагону вперше за тривалий час прибув на міністерський саміт НАТО: не стримувався у критиці союзників та зробив заяви щодо України – подробиці (Відео)Vitalii18 Чер. 17:19When morons are in charge of the USA. :(
- Центр протидії дезінформації викрив російську кінопропаганду як системну загрозу
 Українців попередили про штрафи за камуфляж: коли «піксель» може стати проблемою
 Нейт9 Тра. 14:09Військова і вважаю що носіння форми цивілами це аморально, для мене це на рівні як начепити чужі ордени (ну тобто тіпа приписуєш собі заслуги і досягнення яких ніколи не мав). Виняток - тактичний одяг у волонтерів, вони хоч і не воюють але роблять для перемоги не менше. Ну тобто або працюй на перемогу або не допускай щоб про тебе думали що ти працюєш на перемогу коли це не так
- Втрати військ рф перевищують їхнє поповнення - Жмайло
- СБУ розслідує вербування «злодієм в законі» мешканців Львівщини для роботи на спецслужби РФ
 Музей збройних сил у німецькому Кобленці заборонив українцям відвідувати експозицію
 Ihor Chaban14 Кві. 16:13Бояться що би що???😅
- Угорці обрали свободу, це добра новина для України і Європи - Мерц
- На Закарпатті озброєний чоловік викрав жінку з дитиною, при спробі затримання стріляв у поліцейськогоIhor Chaban14 Кві. 15:59Ужас, народ божеволіє!
 «Сяйво» обходить конкурентів: Українці обрали назву національної LLM
 Alexander30 Бер. 21:47Це просто крінж
- Для важкої роботи. Renault планує запустити 350 людиноподібних роботів на своїх заводахIhor Chaban25 Бер. 13:25350 людей залишуться без роботи! жесть!
- Передача МіГ-29 Україні була хибним рішенням – президент Словаччини
 SR-Team8 Лют. 10:58цитата-Жодна інша країна не вчинила так, щоб після передачі власного озброєння стала покладатися виключно на допомогу своїх сусідів", хочу нагадати ,а Україна за Будапештом як позбулася своєї зброї ,ядерної,літаків ТУ-160 ,теж надіялась на так звані "гарантії" !Щось слабонькі у нас дипломати ,не вміють 'дипломатично"по морді врізати!!!
 Військові показали, як нині виглядає Куп'янськ
 Підтримка (Support)30 Гру. 2025 15:48Сумно ((
- Зеленський обговорив з Мерцом підготовку до зустрічі з Трампом
 Леонід Биков26 Гру. 2025 19:45Балакай не балакай, а путлєр на своїй хвилі...
- Російські спецслужби вербують агентів через TelegramНейт1 Гру. 2025 06:35особисто стикалась ще з іншими методами, військова але думаю цивіли теж можуть зіткнутись з чимось схожим. коли десь в публічних чатах пишеш про свої проблеми (думаю особливо коли це невдоволення своїм командуванням, невдоволення владою або невдоволення роботою правоохоронних органів) то в особисті пишуть люди які тіпа тебе підтримують, більшість наші і пишуть щиро але серед них є і русня. так от з тих хто мені писав один одразу почав з того що він кацап і пропонує перейти до них, звісно одразу послала і заблокувала. а другий довго прикидався нашим (можливо навіть з окупації) і його видавало тільки те що якось надміру цікавили такі речі як де я, де мій підрозділ, скільки нас тут і так далі.. звісно я йому ніхєра не казала і теж залокувала але по факту він тупо намагався маніпулювати і цілком можливо що є лохи які через брак досвіду через отаких от нахаляву нададуть кацапам інфу самі того не розуміючи. самим цим ситуаціям мабуть більше року але можливо кацапи продовжать отак вишукувати людей у яких є певні проблеми які в теорії можуть зробити їх вразливими до маніпуляцій, при тому деякі все ж вміють прикидатися своїми тому все шо нам залишається це звертати увагу на підозрілі моменти типу надмірної цікавості і не довіряти нікому
 Ранкова звичка, яка підсилює мозок і допомагає отримати підвищення — що показало дослідження
 Village UA23 Лис. 2025 23:52пити каву?
- Небезпечна рослина сусіда почала "захоплювати" чужий двір: відео вразило МережуVillage UA22 Лис. 2025 11:19кропива?
- Топ-7 собак, які ніколи не втомлюються: породи для по-справжньому активних сімейVillage UA22 Лис. 2025 11:14там 100% є хаскі)
- Трамп зробив гучну заяву про втрату Україною територійVillage UA22 Лис. 2025 11:12голодний дєдок, вже мікрофон жере)
- Яка зброя реально змінить ситуацію на фронті: експерт відповівVillage UA21 Лис. 2025 18:55якісна)
- Трамп оголосив дедлайн для погодження Україною мирного плануVillage UA21 Лис. 2025 18:54трамп гнилий дєд, який постійно забуває випити таблетки)
- Анджеліна Джолі в ТЦК: Мережа вибухнула мемамиVillage UA5 Лис. 2025 22:22такі новини мені подобаються!
- Орбан розкритикував "невдячність" Києва за підтримку від УгорщиниVillage UA4 Лис. 2025 23:02коли його вже викинуть у вікно?
- Квіти, що захищають оселю від зла й негативуVillage UA4 Лис. 2025 19:00валерянка?
 Фіналісти конкурсу кумедних фото природи 2025 — коли переможець неважливий
 Miro Baida3 Лис. 2025 19:22Дійсно хороша новина
- Чому не можна віджимати пакетик чаю: багато хто не знаєVillage UA2 Лис. 2025 13:56в кого?
- Новорічний зворотний відлік: скільки днів до зустрічі 2026 рокуVillage UA1 Лис. 2025 12:10а хто зустрічатись має?
- Розвідка США розкрила несподівані постачання для війни РФ: що приховують Китай і МоскваVillage UA30 Жов. 2025 11:57моцква пишеться з маленької)
- Туск розніс Орбана: лідер найбіднішої країни в ЄС "зачарований Москвою"Village UA28 Жов. 2025 21:44фото супер!🤣
- Навіщо досвідчені господарі залишають кореневища від капусти після збору врожаю на городіVillage UA24 Жов. 2025 14:14щоб поламати об них ноги.
- Зеленський прибув з візитом до Лондона: з ким зустрінеться президент УкраїниVillage UA24 Жов. 2025 14:13з кимось)
- Росія створила фейковий Telegram, який стежить за користувачами — ЦПДПідтримка (Support)21 Жов. 2025 23:33А оригінальний тоді що робив? ))
- Рада продовжила воєнний стан і мобілізацію, а Бережну призначили міністеркою культури. Головне за день
 Лютий Махновець21 Жов. 2025 22:12"міністерка"?... а якби чоловік, то - "мініструк"?...